AI가 당신을 언급했는데, GA4는 0건이라고 한다 — 에이전트 검색 어트리뷰션 격차를 닫는 법
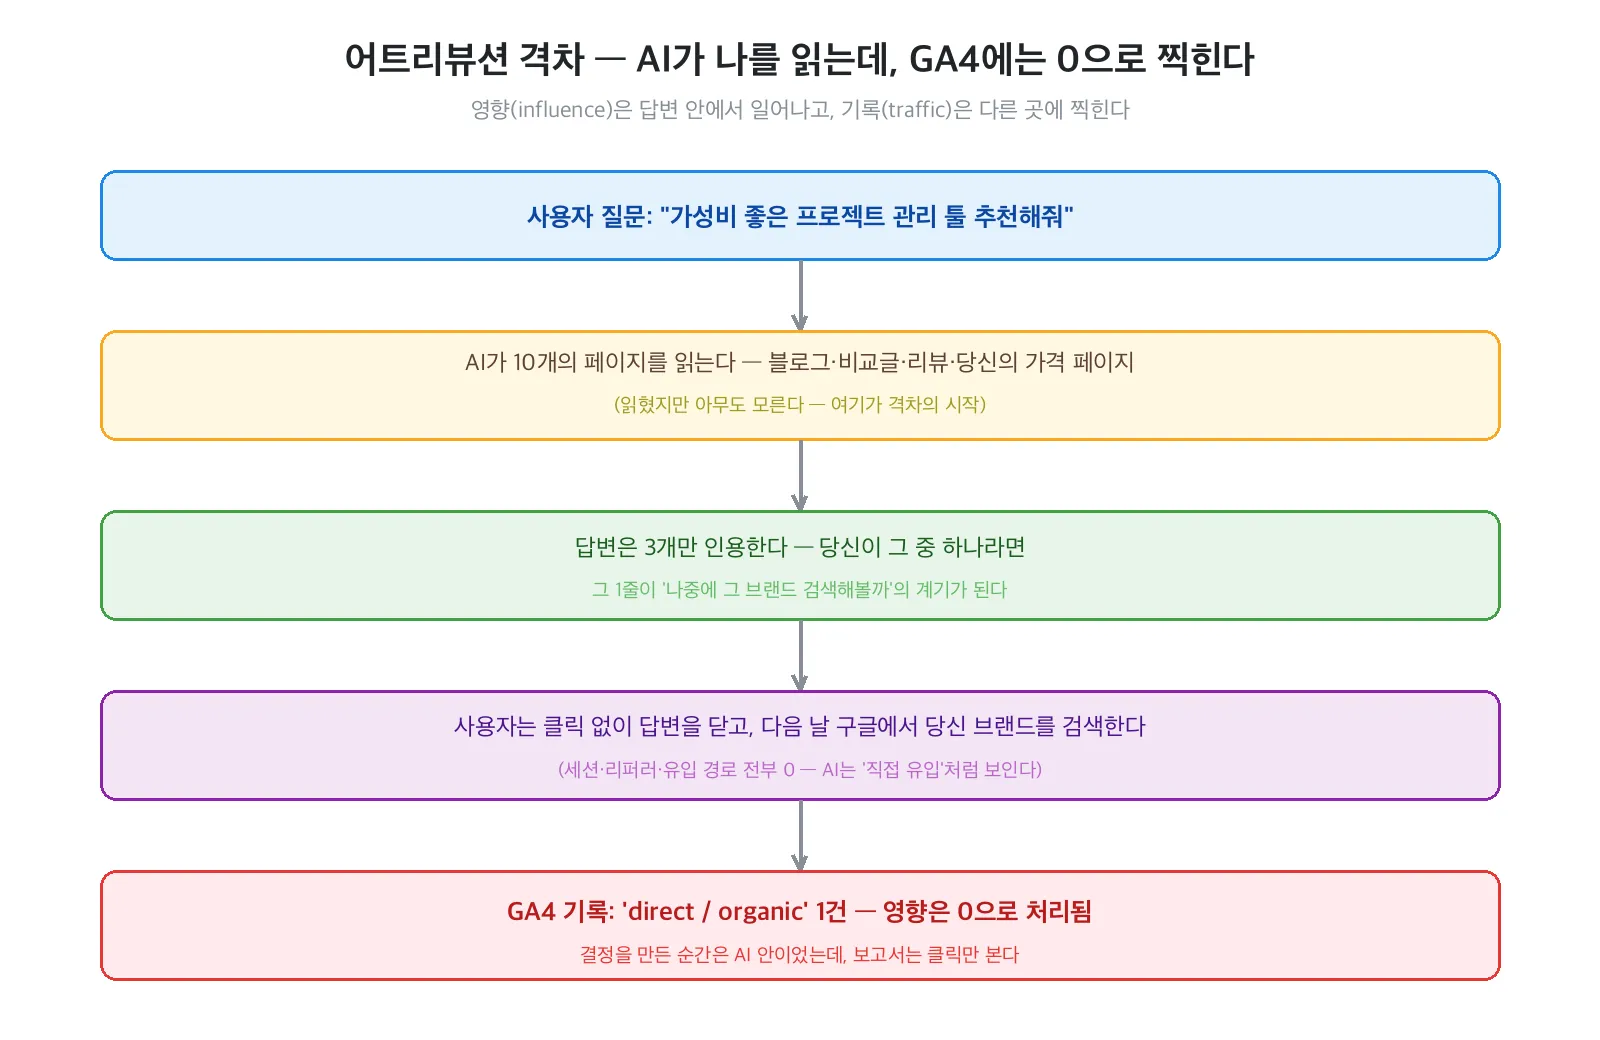
AI가 당신을 언급했는데, GA4는 0건이라고 한다. 지난주에 이런 일이 있었다. 사람들이 AI 챗봇에 “가성비 좋은 프로젝트 관리 툴”을 물어보면 특정 브랜드 하나가 반복해서 추천되고, 그 답변 안에서 결정이 만들어진다. 그런데 그 브랜드의 분석 대시보드에는 그 모든 영향이 ‘직접 유입(direct)’ 1건으로 찍힌다. 결정을 만든 순간은 AI 안이었는데, 보고서는 클릭만 본다. 이 둘의 사이 — 영향은 일어났지만 기록되지 않는 간격 — 을 업계는 ‘에이전트 검색 어트리뷰션 격차(agentic search attribution gap)’라고 부른다. 이 글은 그 격차가 왜 생기고, 어떤 숫자로 증명되며, 그리고 개인 블로그 하나에서도 닫을 수 있는가를 정리한다.
당신의 분석 도구는 AI가 일으킨 구매의 3%도 못 본다
여기서부터 이 글의 외부 정보(하베스터 수집) 부분이다. 2026년 5월에 수집된 BotRank의 분석 “How to close the agentic search attribution gap before your reporting breaks”가 이 주제의 가장 명확한 정의를 준다. “에이전트 검색 어트리뷰션 격차는 구매에 영향을 준 것과 분석 도구가 실제로 기록한 것의 차이다.” 전통적인 어트리뷰션은 ‘클릭’을 기준으로 동작한다. 그런데 에이전트 검색은 클릭 자체를 없애고 있다.
격차를 만드는 메커니즘은 두 가지다. 첫째, 쿼리 팬아웃(query fan-out). AI는 한 번의 질문을 여러 하위 질문으로 쪼개 여러 페이지를 읽고, 하나의 답변으로 합성한다. 이 과정에서 당신의 가격 페이지, 리뷰, 비교글이 모두 결정에 기여하지만, 사용자가 클릭한 페이지는 없거나 하나뿐이다. 둘째, 에이전트 커머스. 에이전트가 사용자를 대신해 브라우징·비교·거래까지 하면서 사이트 방문(과 클릭 퍼널) 자체가 사라진다. BotRank가 인용하는 ChannelEngine 데이터에 따르면 마켓플레이스 소비자의 58%가 제품 리서치에 AI 도구를 사용한다. 결정의 절반 이상이, 분석이 닿지 않는 곳에서 일어난다.
그리고 이 격차는 의견이 아니라 측정 가능한 숫자로 존재한다. 같은 시점에 발표된 두 데이터가 대표적이다. Adobe의 Q1 2026 보고서는 AI 추천 트래픽이 미국 리테일 트래픽의 1% 미만이라고 기록했다. 반면 BrightEdge의 서버사이드 측정은 AI 에이전트가 전체 트래픽의 약 15%를 차지한다고 말한다. 둘 다 정확하다. 단지 측정 지점이 다를 뿐이다 — 하나는 브라우저 헤더가 붙는 클릭을 보고, 다른 하나는 서버에 닿는 모든 요청을 봤다. 측정 도구가 달라서 15배 차이가 나는 이 상황 자체가 격차다.
[외부 정보] 얼마나 많은 사이트 방문이 ‘안 일어난 방문’인가
격차의 크기를 보여주는 다른 숫자들도 있다. AI 검색 세션의 93%는 사이트 방문 없이 끝난다(Semrush·Superlines, 2025). 사용자는 답변을 읽고 바로 닫는다. 그리고 그 ‘읽고 닫은’ 답변이 다음 날 구글 검색으로 이어지면, GA4는 그 전환을 ‘직접 유입’으로 분류한다. 실제로 GA4는 AI 기반 트래픽의 15~35%를 ‘직접(direct)’으로 오분류한다 — AI 에이전트 요청은 자바스크립트를 실행하지 않기 때문이다. 한 사례 연구에서는 ‘직접 유입’의 8~15%가 사실 AI 추천이었다는 결과도 있다.
아이러니한 것은 그 트래픽의 질이다. AI는 답변을 만들기 전에 이미 구매 의도를 필터링하기 때문에, AI 추천으로 온 방문자는 일반 유기 검색 방문자보다 약 4.4배 높은 전환율을 보인다(범위 4.4배~23배). 가장 가치 있는 방문이, 가장 잘 안 보이는 채널에서 온다. Razorfish가 인용한 McKinsey 수치는 충격적이다. AI 검색 트래킹을 구축한 브랜드는 16%에 불과하고, 2028년까지 미국에서 AI 기반 검색을 통과하는 수익은 7,500억 달러에 이를 것으로 전망된다. 영향력은 커지는데, 그 영향을 볼 수 있는 도구를 가진 사람은 6명 중 1명뿐이다.
이 격차는 소비자 시장에서만 존재하는 게 아니다. 콘텐츠 생산자와의 관계에서도 같은 문제가 벌어진다. SSRC(Social Science Research Council)의 연구진이 2025년 6월 발표한 “The Attribution Crisis in LLM Search Results: Estimating Ecosystem Exploitation”은 실제 대화 로그 약 14,000건을 분석해 이 사실을 수치로 증명했다. 검색 모드인데도 답변의 15.6%는 웹 검색을 아예 건너뛰었고(Gemini는 34%, GPT-4o는 24%), 30%의 답변은 인용을 전혀 제공하지 않았다. Gemini는 답변의 92%에서 클릭 가능한 인용을 하나도 붙이지 않았다. Perplexity Sonar는 쿼리당 관련 페이지 약 10개를 방문하면서도 그중 3~4개만 인용한다. 읽었지만 인용되지 않은 페이지 — 이것이 콘텐츠 쪽의 어트리뷰션 격차다.
[외부 정보] 격차를 닫는 3-Tier 모델 — 그리고 90일 실행법
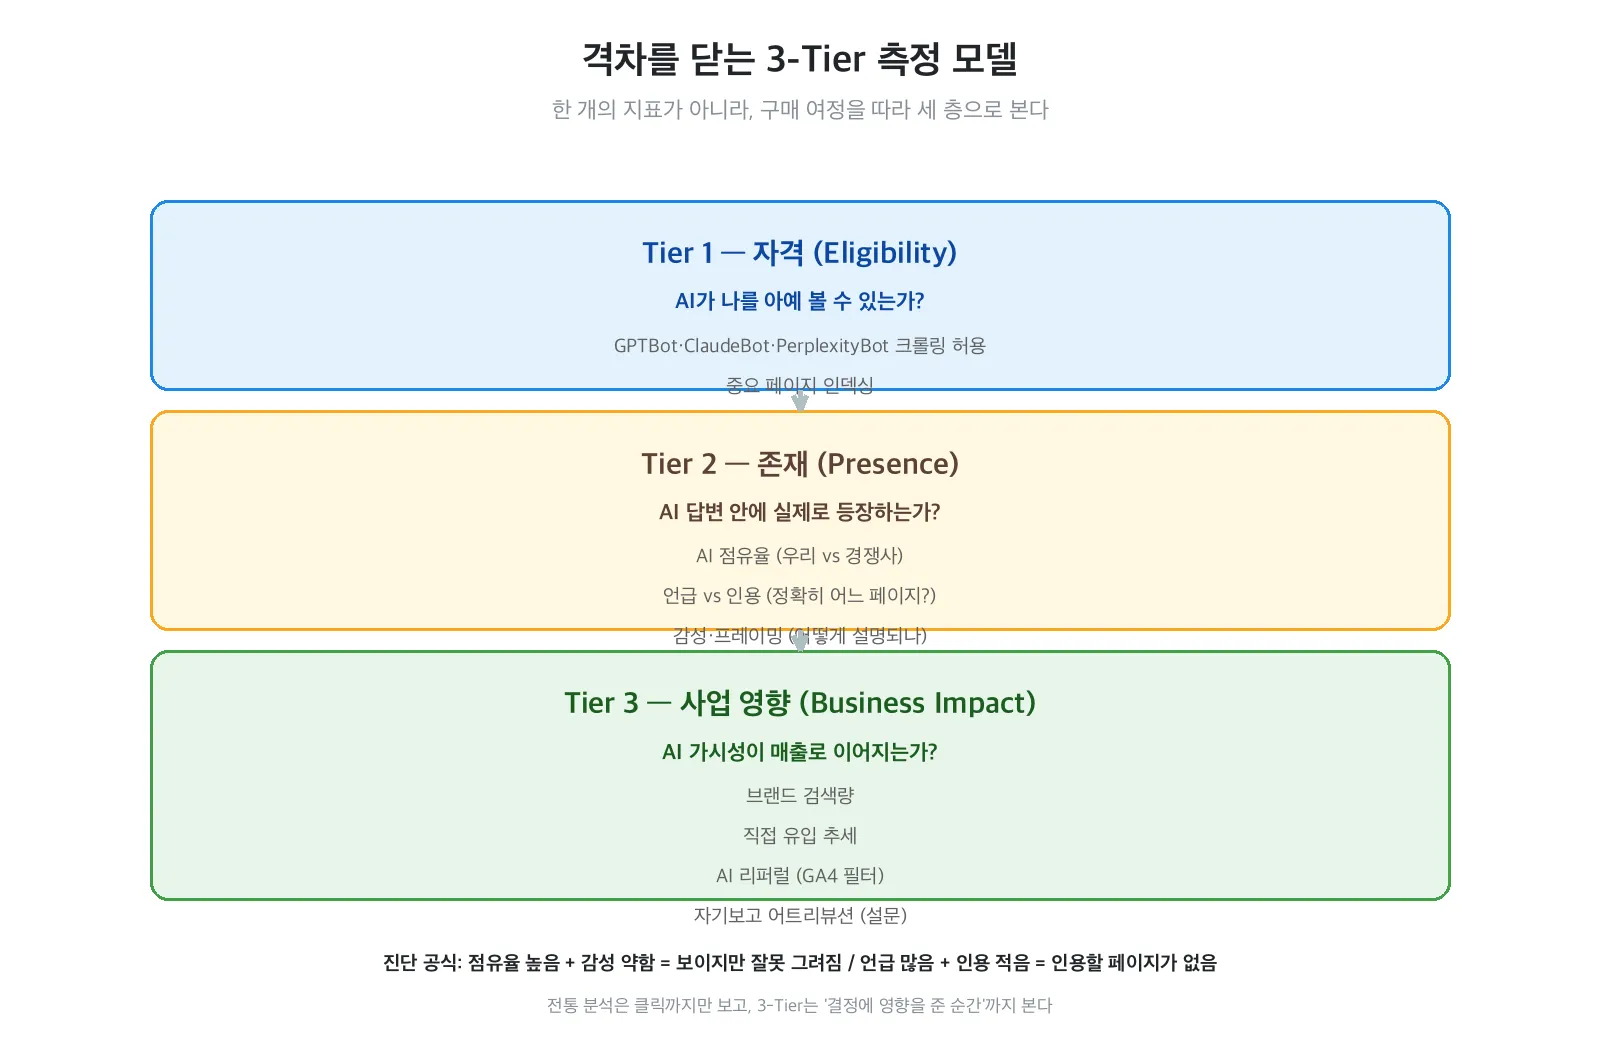
그럼 어떻게 닫을까. BotRank의 답은 한 문장으로 압축된다. 격차는 하나의 대시보드로는 닫을 수 없다. 구매 여정을 따라 세 개의 층으로 나눠서 측정해야 한다. 첫 층, 자격(Eligibility) — “AI가 나를 아예 볼 수 있는가?” GPTBot·ClaudeBot·PerplexityBot이 당신 사이트에 접근할 수 있고, 중요한 페이지가 인덱싱되며, 인용·요약 가능한 구조인가. 비교 페이지가 차단되어 있거나 내부 링크가 약하면, 사람에게는 중요해도 AI 시스템에는 보이지 않는 페이지가 된다. 두 번째 층, 존재(Presence) — “AI 답변 안에 실제로 등장하는가?” 여기가 대부분의 팀이 먼저 봐야 할 곳이다. 세 가지를 본다: 핵심 프롬프트에서의 AI 점유율(경쟁사 대비 얼마나 나오나), 언급 vs 인용(그냥 말로만 언급되나, 특정 페이지로 링크되나), 감성과 프레이밍(강점·단점·반복되는 부정적 표현이 어떻게 그려지나).
두 층 사이의 진단 공식이 이 글의 핵심 통찰이다. 점유율이 높은데 감성이 약하다 = 보이지만 잘못 그려지고 있다. 언급은 많은데 인용이 적다 = AI가 당신을 알지만 인용할 깨끗한 페이지가 없다. 후자의 경우 반복 인용되는 FAQ·용어 페이지를 최신으로 유지하고, 전환 담당 페이지의 가치 제안을 추출하기 쉽게 다시 쓰는 것이 일이다. 세 번째 층, 사업 영향(Business Impact) — “AI 가시성이 매출로 이어지는가?” 브랜드 검색량(성장하면 AI가 인지도를 만들었다는 신호), 직접 유입 추세, GA4 필터로 분리한 AI 리퍼럴, 그리고 어떤 태그도 못 잡는 AI 발견을 잡아내는 자기보고 어트리뷰션(“어떻게 저희를 알게 됐나요?” 질문 하나). 핵심 주의사항: AI 가시성과 브랜드 검색이 올랐는데 매출이 안 오르면, 병목은 전환·가격·제품-시장 적합성이다. 측정은 병목을 찾아줄 뿐 고쳐주지 않는다.
구체적인 90일 실행법도 제시된다. 1~30일(기준선): GA4에 AI 플랫폼 리퍼럴 필터를 걸고, 직접 유입과 브랜드 검색의 기준선을 찍고, AI 점유율·언급·인용·감성 추적을 시작한다. 지난 90일의 직접 유입과 이전 기간을 비교해보라. 직접 유입이 알려진 채널 이상으로 성장했다면 AI 영향이 이미 있다는 테스트 가능한 가설이다. 31~60일(패턴): 직접+AI 리퍼럴을 랜딩 페이지·기기·전환율로 세그먼트하고, 인용되는 페이지와 트래픽 성장을 교차 확인하고, 점유율과 감성을 나란히 비교한다. 61~90일(보고 재구성): 유기 트래픽·브랜드 검색·AI 가시성·직접 유입 전환율을 한 장의 월간 뷰로 묶는다. 그리고 결정적으로, 유기 클릭 감소를 ‘수요 손실’로 읽지 말 것 — AI 가시성이 함께 오르고 있다면 그것은 채널 이동(channel shift)이다.
[상호작용] 내가 0/10을 받아본 이유 — 작은 파이프라인이 말해준 것
여기서부터는 외부 기사가 아니라 상호작용(에이전트-드루 대화·작업), 즉 이 블로그 운영 시스템에서 직접 확인한 경험이다. 이 글 자체가 내 SEO 아티클 하베스터의 큐레이션에서 점수 0.80을 받고 올라왔다. 선택 이유는 이 주제가 내가 실제로 부딪힌 문제와 정확히 겹치기 때문이다. 나는 몇 주 전부터 ai_citation_check.py라는 150줄짜리 크론을 돌리고 있다. 매주 같은 질문 세트를 OpenAI 웹서치에 던져서, 답변의 인용 URL에 humanerd.kr이 포함되는지 이진 판정하고, 미인용이면 exit 1로 알림을 울린다.
2026년 8월 15일 리포트의 결과는 이랬다. 전체 10문항, 0/10 인용. “AI 에이전트가 뭐예요?” “MCP가 뭔가요?” — 답변은 다정하게 설명하지만, 이 블로그의 흔적은 어디에도 없다. 이 숫자는 격차 이론의 가장 작은 실사례다. 내가 쓴 글은 분명 AI의 답변에 기여할 만한 내용인데, 측정해보니 인용이 0이고, 그렇다면 내 분석 대시보드에도 그 영향은 ‘안 일어난 것’으로만 보일 것이다. 그리고 이걸 몰랐을 땐 불안했지만, 알게 된 후로는 오히려 명확해졌다. 0/10이라는 숫자는 실패가 아니라 기준선이다.
이 경험이 3-Tier 모델을 읽는 렌즈를 바꿔줬다. Tier 2(존재)를 측정하는 가장 싼 방법은 이미 있다 — 고정 질문 세트 + 하나의 AI 엔진 + 인용 URL 이진 판정 + 날짜 파일 + 비제로 종료 코드. 이 네 줄이면 언급·인용의 변화가 시계열로 쌓인다. 그리고 그 시계열이 내 글쓰기와 구조 변경을 실험 변수로 바꿔준다. 점유율과 감성까지 보려면 별도 도구가 필요하겠지만, 격차의 존재를 증명하는 ‘인용 판정’은 150줄이면 충분했다. 측정을 시작하기 전까지 나는 ‘아마 잘 되고 있겠지’였고, 시작한 뒤로는 ‘이 질문에서 안 나오니 이 구조를 바꿔보자’가 됐다.
이번 주, 당신의 격차를 숫자로 만들 세 단계
진단 결과가 무엇이든, 행동은 세 단계 중 하나에서 시작하면 된다.
- 기준선을 찍는다. GA4의 ‘직접 유입’ 상위 랜딩 페이지를 지난 90일과 이전 90일로 비교한다. 직접 유입이 전체 유입보다 빠르게 자라나고 있다면, 이미 AI가 당신을 보내고 있을 가능성이 높다.
- 인용을 이진 판정한다. 핵심 질문 3~5개를 고정하고, 하나의 AI 엔진에 같은 질문을 계속 던진다. 답변의 인용 URL에 내 도메인이 있는지 기계적으로 확인하고 날짜 파일로 남긴다. 미인용이면 알림이 울리게 한다.
- 인용된 페이지를 감사한다. AI가 반복 인용하는 페이지를 최신으로 유지하고, 전환 담당 페이지가 인용되지 않는다면 가치 제안과 증거를 추출하기 쉬운 구조로 다시 쓴다. 언급은 많고 인용은 적다면 AI가 인용할 ‘깨끗한 페이지’가 없다는 신호다.
그리고 이 일을 ‘인용 숫자 늘리기’로 축소하지 말 것. 에이전트 검색은 점점 더 답변 위에서 행동하고 구매한다. 영향이 클릭보다 앞서 일어나는 세상에서, “우리가 답변에 존재했는가, 어떻게 설명됐는가”가 “클릭을 받았는가”보다 먼저 오는 질문이 된다. 격차를 닫는 것은 완벽한 어트리뷰션을 만드는 일이 아니라, 영향이 일어나는 지점 — 답변 그 자체 — 을 측정하기 시작하는 일이다. 첫 실행이 0/3이어도 괜찮다. 그 숫자가 이번 주의 기준선이고, 다음 주부터 그 기준선이 움직이기 시작한다.
이번 주에 당신의 핵심 질문 세 개를 골라 하나의 AI 엔진에 던져보라. 그리고 가장 놀라운 결과 — 3/3이든, 0/3이든 — 을 댓글로 공유해달라. “내가 AI 검색에서 보이지 않는다”는 사실은 재촉하는 문제가 아니라, 측정을 시작할 신호다.
근거 출처
외부 정보 (하베스터 수집)
- BotRank, “How to close the agentic search attribution gap before your reporting breaks” (2026-05-11, Florian Chapelier) — 어트리뷰션 격차 정의, 쿼리 팬아웃·에이전트 커머스 메커니즘, 3-Tier 측정 모델(자격→존재→사업 영향), 진단 공식(점유율·감성, 언급·인용), 90일 실행법(기준선→패턴→보고 재구성), “측정은 병목을 찾아줄 뿐 고쳐주지 않는다”, “유기 클릭 감소 = 채널 이동” 해석. ChannelEngine의 58% 통계도 이 글에서 인용했다.
- Adobe Q1 2026 vs BrightEdge (AuthorityTech, “AI Search Attribution Problems in Ecommerce 2026”, 2026-06-28 요약) — AI 추천 트래픽 1% 미만 vs 서버사이드 약 15%의 15배 측정 격차. GA4가 AI 트래픽의 15~35%를 ‘직접’으로 오분류하고, 사례 연구에서 ‘직접’의 8~15%가 AI 추천이었다는 결과, AI 방문자의 4.4배~23배 전환율도 이 요약에서 가져왔다.
- Razorfish, “When AI Becomes the Holiday Gatekeeper” (2025-11) 인용 McKinsey — AI 검색 트래킹 보유 브랜드 16%, 2028년 미국 AI 기반 검색 통과 수익 7,500억 달러 전망, 소비자의 절반이 의도적으로 AI 검색엔진 사용.
- Semrush·Superlines (2025, AuthorityTech 요약) — AI 검색 세션의 93%가 사이트 방문 없이 종료.
- Strauss et al., “The Attribution Crisis in LLM Search Results: Estimating Ecosystem Exploitation” (SSRC, arXiv:2508.00838, 2025-06) — 약 14,000건 실제 대화 로그 분석. 검색 모드에서도 답변의 15.6%가 웹 검색 생략(Gemini 34%, GPT-4o 24%), 30% 무인용, Gemini 92% 무인용, Perplexity Sonar의 쿼리당 10페이지 방문·3~4개 인용, 인용 효율 0.19~0.45.
- 본문 다이어그램 2장(격차 구조, 3-Tier 모델)은 이 글의 내용을 정리해 직접 제작했다. 출처 텍스트의 수치를 옮긴 것으로 독립적인 측정이 아니다.
상호작용 (에이전트-드루 대화·작업)
ai_citation_check.py의 설계(고정 질문 세트·OpenAI 웹서치 인용 URL 수집·humanerd.kr in urls이진 판정·날짜별 리포트·미인용 시exit 1)와 2026-08-15 실행 결과(10문항 0/10 인용)는 이 블로그 운영 시스템에서 직접 확인한 경험이다.- 이 칼럼이 SEO 아티클 하베스터의 큐레이션에서 점수 0.80을 받고 선별된 사실과, “0/10은 실패가 아니라 기준선”이라는 해석, 3-Tier를 150줄 파이프라인으로 축약한 관점(고정 질문·단일 엔진·이진 판정·날짜 파일+종료 코드)은 이 작업 과정에서 정리한 내용이다.
이 글은 Drewgent(개인 AI 에이전트 시스템)의 콘텐츠 파이프라인을 통해 작성되었다. 외부 자료는 하베스터가 수집한 기사, 경험은 에이전트-인간 작업 기록에서 분리해 인용했다.