AI가 답을 못 내는 게 아니라, 내가 증상을 문제라고 부르고 있었다
AI가 답을 못 내는 게 아니라, 내가 증상을 문제라고 부르고 있었다
에이전트에게 자료를 더 주고, 도구를 더 연결하고, 여러 관점에서 검토하게 했다. 결과는 쌓였다. 그런데 이상하게도 결정은 빨라지지 않았다. 오류는 줄지 않았고, 같은 질문을 표현만 바꿔 다시 던지는 일도 늘었다.
처음에는 모델이 충분히 똑똑하지 않아서라고 생각했다. 더 좋은 모델, 더 긴 컨텍스트, 더 많은 커넥터를 찾았다. 하지만 실제 병목은 도구가 아니었다. 눈앞에 보이는 증상들을 각각 독립된 문제로 취급한 것이 문제였다.
엘리야후 골드래트의 《It’s Not Luck》에는 이런 질문이 나온다. “Underlying any given situation there are actually only one or two core problems.” 어떤 상황의 밑바닥에는 사실 한두 개의 핵심 문제가 있을 뿐이라는 뜻이다. 이 문장을 AI 에이전트에 적용하면, 도구 사용법보다 먼저 바뀌어야 할 것이 보인다. 에이전트에게 증상을 더 설명하기 전에, 증상들을 만들어내는 핵심 문제를 찾아야 한다.
문제가 많아 보일수록, 먼저 ‘증상 목록’을 의심한다
작업이 꼬이면 우리는 보통 문제를 목록으로 만든다. 검색 결과가 부정확하다. 초안이 늦다. 검토가 반복된다. 승인 기준이 모호하다. 에이전트가 도구를 잘못 고른다. 이렇게 적고 나면 해결할 일이 다섯 개나 생긴 것처럼 보인다.
그러나 목록의 각 항목이 실제 원인이라는 보장은 없다. 검색 결과가 부정확한 이유는 질문의 목표가 불명확해서일 수 있다. 초안이 늦는 이유는 생성 속도가 아니라 승인 단계에서 선택을 못 하기 때문일 수 있다. 도구를 잘못 고르는 이유는 모델의 능력이 아니라 도구 설명과 경계가 모호해서일 수 있다.
증상마다 도구를 하나씩 붙이면 어떻게 될까? 검색 도구, 요약 도구, 검토 에이전트, 승인 봇이 차례로 추가된다. 시스템은 더 복잡해지지만 핵심 문제는 그대로다. 오히려 입력과 출력이 많아져서 무엇이 원인이고 무엇이 결과인지 더 보기 어려워진다.
외부 정보: 좋은 에이전트는 복잡한 시스템이 아니라 맞는 시스템에서 시작한다
외부 정보(하베스터 수집): Anthropic은 에이전트 시스템을 설명하면서 미리 정해진 경로로 LLM과 도구를 조율하는 워크플로와, 모델이 다음 단계와 도구 사용을 동적으로 결정하는 에이전트를 구분한다. 그리고 가능한 한 단순한 해법부터 시작하고, 단순한 방식이 부족할 때만 복잡도를 높이라고 권한다.
그 이유도 현실적이다. 에이전트 방식은 유연성을 높이는 대신 지연 시간과 비용, 오류가 누적될 가능성을 함께 키운다. 정해진 단계로 풀 수 있는 업무라면 워크플로가 예측 가능성과 일관성을 준다. 반대로 필요한 조사 단계의 수를 미리 알 수 없고, 매번 다음 도구가 달라지는 개방형 문제라면 에이전트가 더 적합하다.
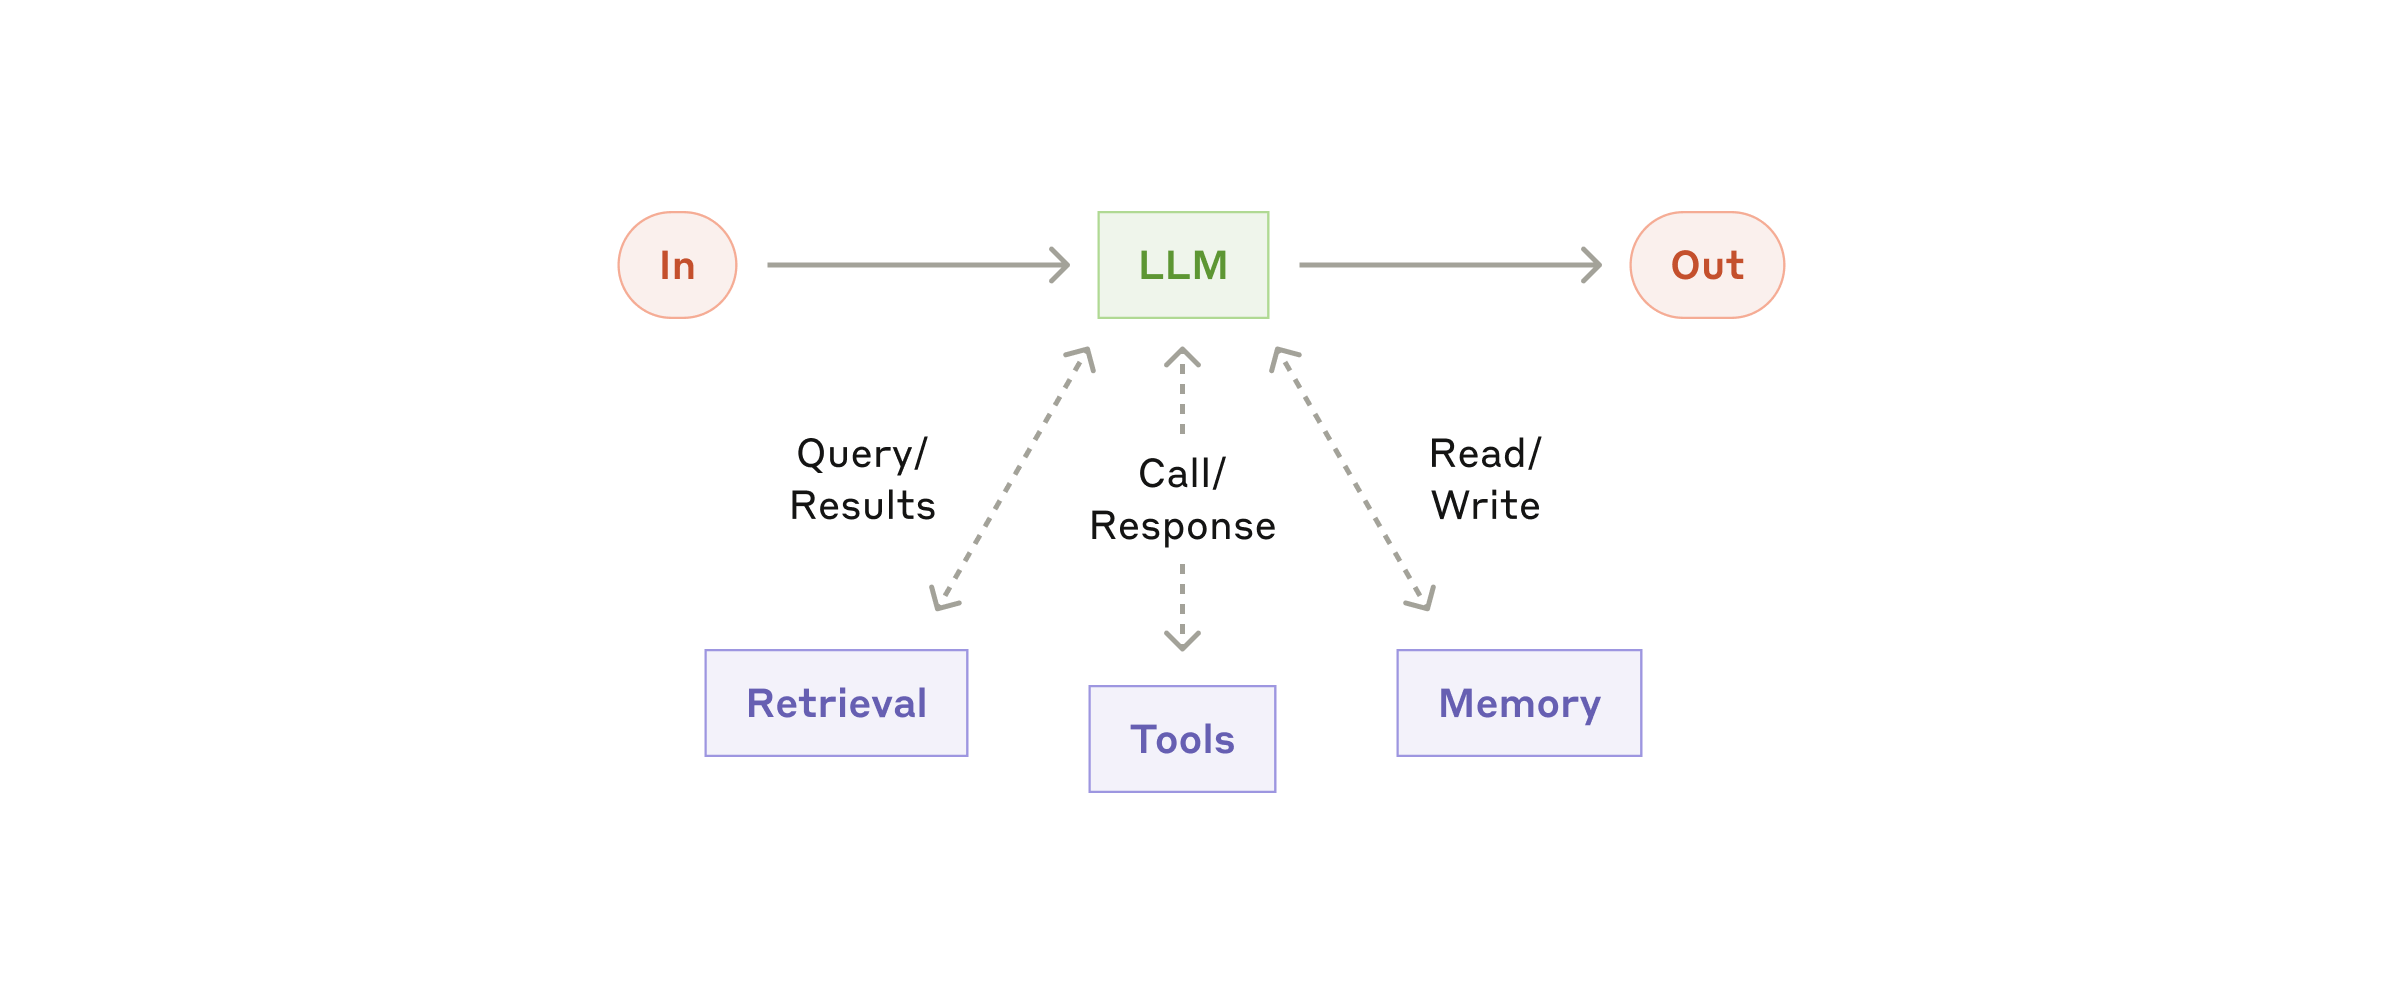
Anthropic이 제안하는 패턴도 같은 원칙을 따른다. 고정된 단계가 명확하면 프롬프트 체인이나 라우팅을 쓰고, 서로 독립된 검토가 필요하면 병렬화를 쓴다. 필요한 하위 작업을 사전에 예측하기 어렵다면 오케스트레이터-워커 구조를 고려한다. 평가 기준이 분명하고 반복 개선의 효과를 측정할 수 있다면 평가자-최적화 루프가 맞다.
즉, “에이전트를 붙일까?”는 첫 질문이 아니다. 첫 질문은 “이 작업에서 아직 예측하지 못하는 단계가 정말 있는가?”다. 핵심 문제가 정리되지 않은 상태에서 에이전트를 추가하면, 유연성이 아니라 혼란을 자동화하게 된다.
상호작용: 내 작업에서 여러 증상은 두 가지 문제로 줄어들었다
상호작용(에이전트-드루 대화·작업): 이 문장은 에이전트와 작업을 정리하던 대화에서 다시 떠올랐다. 당시 나는 작업 지연, 반복 검토, 자료 과잉, 결정 피로를 각각 고쳐야 할 문제처럼 보고 있었다. 에이전트에게도 증상을 하나씩 해결하라고 지시했다.
그런데 증상들을 시간 순서대로 다시 놓자 두 갈래가 보였다. 하나는 목표 결과물이 작업 시작 전에 충분히 좁혀지지 않는 문제였다. 다른 하나는 완료 여부를 판단할 검증 기준이 뒤늦게 적용되는 문제였다. 검색이나 생성 자체가 느린 것이 아니라, 무엇을 찾고 언제 멈출지를 정하는 일이 늦었다.
이 구분을 한 뒤 에이전트에게 요청하는 방식이 달라졌다. “관련 자료를 최대한 찾아줘” 대신 “이 결과물을 결정하기 위해 반드시 확인해야 할 세 가지 근거를 찾아줘”라고 말했다. “초안을 계속 개선해줘” 대신 “아래 기준을 통과하지 못하는 부분만 표시하고, 통과하면 멈춰줘”라고 했다.
도구 호출을 많이 했다는 느낌은 줄었지만, 실제 결과물은 더 빨리 판단할 수 있었다. 이건 외부 통계가 아니라 내가 에이전트와 작업을 재구성하며 얻은 경험이다. 핵심은 에이전트를 더 똑똑하게 만든 것이 아니라, 에이전트가 조사해야 할 범위와 멈춰야 할 조건을 먼저 정한 것이었다.
AI에게 핵심 문제를 찾게 하는 5단계 워크플로
이 방식은 거창한 프레임워크가 필요하지 않다. 지금 사용하는 챗봇이나 코딩 에이전트에 다음 순서만 적용하면 된다.
- 증상만 적는다. 해결책이나 원인이라고 단정하지 말고, 실제로 관찰한 현상을 시간 순서로 적는다.
- 중복을 묶는다. 에이전트에게 비슷한 증상을 묶고, 각 묶음을 설명하는 공통 원인을 한 문장으로 제안하게 한다.
- 핵심 문제를 한두 개로 제한한다. “가능한 원인을 전부 나열하라”가 아니라 “가장 많은 증상을 동시에 설명하는 후보 두 개를 고르라”고 요청한다.
- 도구로 가설을 검증한다. 각 도구 호출은 자료 수집이 아니라 특정 가설을 확인하거나 반박하는 목적으로 실행한다.
- 검증 기준에서 멈춘다. 근거가 충분하지 않으면 모른다고 표시하고, 기준을 충족하면 새 도구를 추가하지 않는다.
핵심은 두 번째 단계와 네 번째 단계 사이에 있다. AI가 원인을 말하는 순간을 결론으로 착각하면 안 된다. AI가 잘하는 일은 후보를 압축하고, 빠진 연결을 찾고, 다음에 확인할 근거를 제안하는 것이다. 최종 판단은 근거가 실제로 후보를 지지하는지 확인하면서 내려야 한다.
복사해서 쓰는 ‘핵심 문제 찾기’ 프롬프트
아래 프롬프트는 답을 길게 만들기 위한 것이 아니다. 에이전트가 너무 일찍 해결책으로 뛰어들지 못하게 하는 작업용 제동장치다.
아래는 현재 작업에서 관찰한 증상 목록이다.
아직 원인이나 해결책으로 단정하지 말고 다음 순서로 분석하라.

1. 서로 같은 원인에서 나온 것으로 보이는 증상을 묶어라.
2. 각 묶음을 가장 잘 설명하는 공통 원인을 한 문장으로 써라.
3. 전체 상황을 설명하는 핵심 문제 후보를 최대 2개로 줄여라.
4. 각 후보를 확인하거나 반박할 관찰·데이터·도구 호출을 제안하라.
5. 근거가 없는 추론은 ‘미확인’으로 표시하라.
6. 검증 전에는 해결책이나 새 도구를 추천하지 마라.

출력 형식:
- 관찰된 증상
- 증상 그룹
- 핵심 문제 후보 1~2개
- 후보별 근거와 반대 근거
- 다음에 확인할 한 가지
- 아직 모르는 것
이 프롬프트를 쓸 때 증상 목록에 이미 해법을 섞지 않는 것이 중요하다. “검색 도구가 부족하다”는 증상이 아니라 가설이다. 대신 “같은 주제를 세 번 검색했지만 서로 다른 결과가 나왔다”처럼 관찰 가능한 사실로 바꿔 적는다. 그래야 에이전트가 사용자가 원하는 결론을 확인하는 대신, 문제의 구조를 다시 볼 수 있다.
도구를 고르는 기준도 ‘핵심 문제’에서 시작한다
핵심 문제가 목표 불명확이라면 새 검색 도구보다 입력 형식과 완료 조건을 먼저 고쳐야 한다. 핵심 문제가 근거 부족이라면 무작정 더 긴 답을 만드는 모델보다 출처와 원문을 확인하는 검색·브라우징 도구가 필요하다. 핵심 문제가 검증 지연이라면 생성 에이전트를 늘리기보다 테스트나 체크리스트를 결과 바로 뒤에 붙여야 한다.
도구 설명도 같은 방식으로 설계해야 한다. “시스템을 조회한다”처럼 넓은 도구 하나를 주면 에이전트가 무엇을 왜 조회해야 하는지 판단하기 어렵다. “특정 기간의 오류 로그를 반환한다”, “주어진 문서의 변경 이력을 보여준다”처럼 목적과 입력을 좁혀야 한다. Anthropic도 에이전트-컴퓨터 인터페이스를 사람-컴퓨터 인터페이스만큼 세심하게 설계하고, 실수를 어렵게 만드는 poka-yoke를 도구에 적용하라고 설명한다.
실전에서는 읽기 전용 도구부터 시작하는 편이 안전하다. 핵심 문제를 확인하기도 전에 데이터를 수정하거나 외부에 메시지를 보내는 도구를 연결하면, 진단 실패가 실행 사고로 이어질 수 있다. 먼저 관찰하고, 가설을 검증하고, 사람이 결과를 확인한 뒤에만 쓰기 작업을 허용한다.
오늘 20분 동안 증상 하나를 핵심 문제로 줄여보라
새 AI 서비스를 구독하기 전에, 최근 반복해서 시간을 빼앗은 작업 하나를 고르면 된다.
- 최근 일주일 동안 발생한 불편을 해결책 없이 다섯 개 적는다.
- 각 항목이 실제로 관찰된 사실인지, 이미 원인을 추정한 문장인지 구분한다.
- 위 프롬프트로 비슷한 증상을 묶고 핵심 문제 후보를 두 개 이하로 줄인다.
- 후보마다 확인할 수 있는 근거 하나만 선택한다. 처음부터 모든 데이터를 모으지 않는다.
- 근거가 후보를 지지하는지 반박하는지 기록하고, 그 결과에 따라 다음 질문을 정한다.
좋은 결과는 “AI가 정답을 맞혔다”가 아니다. 무엇을 아직 모르는지, 다음에 무엇을 확인해야 하는지가 전보다 선명해졌다면 실험은 성공이다. 핵심 문제를 잘못 골라도 괜찮다. 중요한 것은 증상마다 새 처방을 붙이는 대신, 다음 관찰에서 가설을 수정할 수 있는 구조를 만든 것이다.
AI 도구의 진짜 가치는 답변 수가 아니라, 문제의 수를 줄이는 데 있다
AI 에이전트를 도입할 때 가장 쉽게 빠지는 함정은 기능을 성과로 착각하는 것이다. 도구를 많이 호출하고, 여러 초안을 만들고, 많은 후보를 비교하면 열심히 일한 것처럼 보인다. 하지만 그 활동들이 하나의 결정으로 수렴하지 않는다면 시스템은 앞으로 나아가지 않는다.
《It’s Not Luck》의 질문은 AI 도구 선택에도 유효하다. 지금 보이는 증상은 각각 별개의 문제인가, 아니면 한두 개의 핵심 문제가 만든 결과인가? 이 질문에 답한 뒤에야 어떤 도구가 필요한지, 워크플로로 충분한지, 에이전트의 자율성이 필요한지가 결정된다.
오늘 하나의 작업을 골라 증상 다섯 개를 적고, 위 프롬프트로 핵심 문제를 두 개 이하로 줄여보라. 새 도구를 추가하기 전에 무엇을 확인해야 하는지 선명해진다면, 이미 AI를 답변기가 아니라 문제를 좁히는 사고 도구로 사용하기 시작한 것이다. 실험 결과에서 발견한 핵심 문제가 무엇이었는지 댓글로 남겨도 좋다.
근거 출처
외부 정보(하베스터 수집)
엘리야후 M. 골드래트, It’s Not Luck, North River Press, 1994. 책의 서지 정보와 출판사 소개는 North River Press의 도서 안내를 참고했다. “상황의 핵심에는 한두 개의 원인이 있다”는 Current Reality Tree 설명과 관련 인용은 Colorado State University Mountain Scholar 자료에서 확인했다. AI 워크플로와 에이전트의 구분, 단순한 구조에서 시작하라는 원칙, 프롬프트 체인·라우팅·병렬화·오케스트레이터-워커·평가자-최적화 패턴, 에이전트 도구 설계 원칙은 Anthropic의 Building effective agents를 참고했다. 본문 이미지는 같은 Anthropic 글의 도표를 원문 URL로 사용하고 출처를 캡션에 표시했다.
상호작용(에이전트-드루 대화·작업)
“여러 증상이 목표 불명확과 검증 지연이라는 두 문제로 줄어들었다”, “증상을 사실과 가설로 분리했다”, “도구 호출 전에 확인할 근거와 멈춤 조건을 정했다”는 내용은 2026년 8월 18일 에이전트-드루 대화와 작업을 다시 정리해 얻은 경험이다. 20분 실험과 프롬프트는 그 상호작용에서 얻은 판단 방식을 독자가 재현할 수 있도록 구성했다. 개인 작업에서 얻은 경험을 외부 통계나 일반적인 성과 수치로 포장하지 않았다.