AI 검색에 노출됐다는 보고서, 아직 믿지 마세요
AI 검색에 노출됐다는 보고서, 아직 믿지 마세요
“이번 달 AI 검색 가시성이 18% 올랐습니다.” 이 문장을 성과 보고서에 넣기 전에 한 가지를 물어야 합니다. 그 상승을 만든 것이 우리 페이지의 변화였습니까, 아니면 검색 모델과 프롬프트가 우연히 바뀐 것입니까? 지금 AI 검색 측정의 가장 큰 문제는 노출을 못 보는 데 있지 않습니다. 노출을 봤지만, 무엇이 효과를 냈는지 설명하지 못하는 데 있습니다.
브랜드명을 ChatGPT·Claude·Perplexity에 입력해 보고, 인용 여부를 스프레드시트에 기록하는 것만으로는 부족합니다. 그 기록은 “그날 그 질문에 나왔다”는 스냅샷일 뿐입니다. 다음 콘텐츠 회의에서 “그래서 무엇을 바꿀까요?”라는 질문이 나오면 다시 추측으로 돌아갑니다. AI 검색을 실제 워크플로에 넣으려면, 가시성 대시보드가 아니라 작은 실험의 반복이 필요합니다.
가시성은 결과를 보여주고, 실험은 이유를 밝혀준다
[외부 정보] Search Engine Journal이 2026년 7월 소개한 seoClarity 웨비나의 출발점은 명확합니다. “가시성 점수는 나타났는지 알려주지만, 페이지 성과와 스플릿 테스트는 우리가 한 일이 실제로 중요했는지 알려준다”는 주장입니다. 웨비나에서 소개한 방법은 ChatGPT, Claude, Perplexity, Gemini, Google의 AI 검색 화면을 한 번의 점검으로 평가하지 않고, 프롬프트와 페이지를 묶어 시간에 따라 추적하는 방식입니다.
그 사례가 설득력을 얻는 이유는 FAQ라는 전술이 특별해서가 아닙니다. 약 1,000개 프롬프트를 측정한 테스트에서 테스트 페이지에 FAQ 섹션을 추가하자 대조군보다 AI 인용이 늘었고, FAQ를 제거하자 인용도 다시 내려갔습니다. 상승만 관찰했다면 상관관계입니다. 넣었을 때 올라가고, 뺐을 때 내려간 리버전(reversion)까지 확인했기 때문에 인과관계에 가까운 증거가 됐습니다.
중요한 대목은 같은 방법으로 진행한 다른 두 테스트가 FAQ와 같은 성공을 내지 않았다는 점입니다. 메타 디스크립션과 리스트형 포맷 변경은 기대한 결과를 보여주지 않았습니다. AI 검색 최적화의 교훈은 “FAQ를 넣어라”가 아니라 유행하는 전술도 테스트하지 않으면 업무 규칙이 될 수 없다는 데 있습니다.
LLM에는 50:50 A/B 테스트가 없다
웹사이트라면 방문 트래픽을 두 버전으로 나누고 전환율을 비교할 수 있습니다. 그러나 ChatGPT나 Gemini의 응답 트래픽을 우리가 통제할 수는 없습니다. 같은 질문도 시점과 계정, 모델 상태에 따라 다른 답변을 만들 수 있습니다. 그래서 AI 검색 실험은 방문자 분할 대신 변경 페이지와 비슷한 대조군 페이지를 둡니다.
대조군이 없으면 상승은 언제나 모델 업데이트와 경쟁해야 한다. 대조군이 있으면 배경 노이즈를 걷어내고 페이지 변화의 신호를 볼 수 있다.
실험 전에 베이스라인을 기록하고, 변경 뒤에도 미리 정한 테스트 기간을 유지해야 하는 이유가 여기에 있습니다. 하루 전후의 차이를 성과로 부르면 노이즈를 전략으로 착각하게 됩니다. 측정 단위도 “브랜드가 언급됐는가”에서 “이 프롬프트에 대해 원하는 URL이 인용됐는가”로 좁혀야 합니다.
테스트할 질문은 “거의 이기고 있는” 것부터 고른다
[외부 정보] seoClarity가 제안한 골든 프롬프트 세트는 인지·검토·비교·구매·지원 등 퍼널 전체의 질문을 모은 뒤, 각 질문을 단계별로 태깅합니다. 그중 먼저 볼 것은 브랜드와 주제가 이미 관련 있지만, AI가 아직 우리가 원하는 URL을 연결하지 않은 질문입니다. 발표자는 이를 “거의 이기고 있는” 상태로 설명했습니다.
이 우선순위는 실무적으로 중요합니다. 처음부터 경쟁이 가장 치열한 질문을 고르면 실험이 실패했을 때 전술과 가설을 함께 잃습니다. 반대로 이미 관련성이 있는 질문에서 페이지 한 요소를 바꾸면, 작은 승리라도 팀이 다음 실험을 승인할 근거가 됩니다. AI 검색 실험은 SEO 체크리스트가 아니라 가설의 난이도를 조절하는 운영입니다.
실제 업무에 넣는 5단계 실험 루프
거대한 AEO 프로젝트를 시작할 필요는 없습니다. 다음 다섯 칸만 문서나 스프레드시트에 만들면 첫 실험의 형태가 생깁니다.
- 질문을 고른다. 사업과 연결된 프롬프트를 퍼널 단계별로 모으고, 각 질문에 “인용되어야 할 URL”을 하나씩 지정합니다.
- 베이스라인을 남긴다. 변경 전에 프롬프트, 답변, 인용 URL, 엔진, 확인 날짜를 같은 형식으로 기록합니다. 브랜드 언급과 원하는 페이지 인용을 별도 칸으로 나눕니다.
- 대조군을 묶는다. 같은 템플릿·주제·트래픽 성격을 가진 페이지를 골라 테스트 기간에는 바꾸지 않습니다. 대조군은 완벽한 복제가 아니라 변동을 비교하는 안전장치입니다.
- 한 번에 한 가설만 바꾼다. FAQ, 메타 설명, 목록 포맷, 구조화 데이터, 본문 개편을 한꺼번에 넣지 않습니다. 무엇이 움직였는지 다시 설명할 수 있어야 합니다.
- 되돌림까지 기록한다. 상승 여부에서 끝내지 말고, 가능하다면 변경을 제거한 뒤 결과가 기준선 쪽으로 돌아오는지 확인합니다. 그때 비로소 다음 페이지에 확대 적용할 근거가 생깁니다.
판정은 세 가지면 충분합니다. 테스트 페이지만 개선되면 가설을 유지하고, 테스트와 대조군이 함께 움직이면 외부 변동을 의심하고, 아무 변화가 없으면 그 전술을 확대하지 않습니다. 실패를 숨기지 않는 구조가 있어야 도구 비용도 줄어듭니다. 도구가 내놓는 점수보다 중요한 것은 다음 결정을 바꿀 수 있는 결과입니다.
Search Console은 정답이 아니라 측정 루프의 한 칸이다
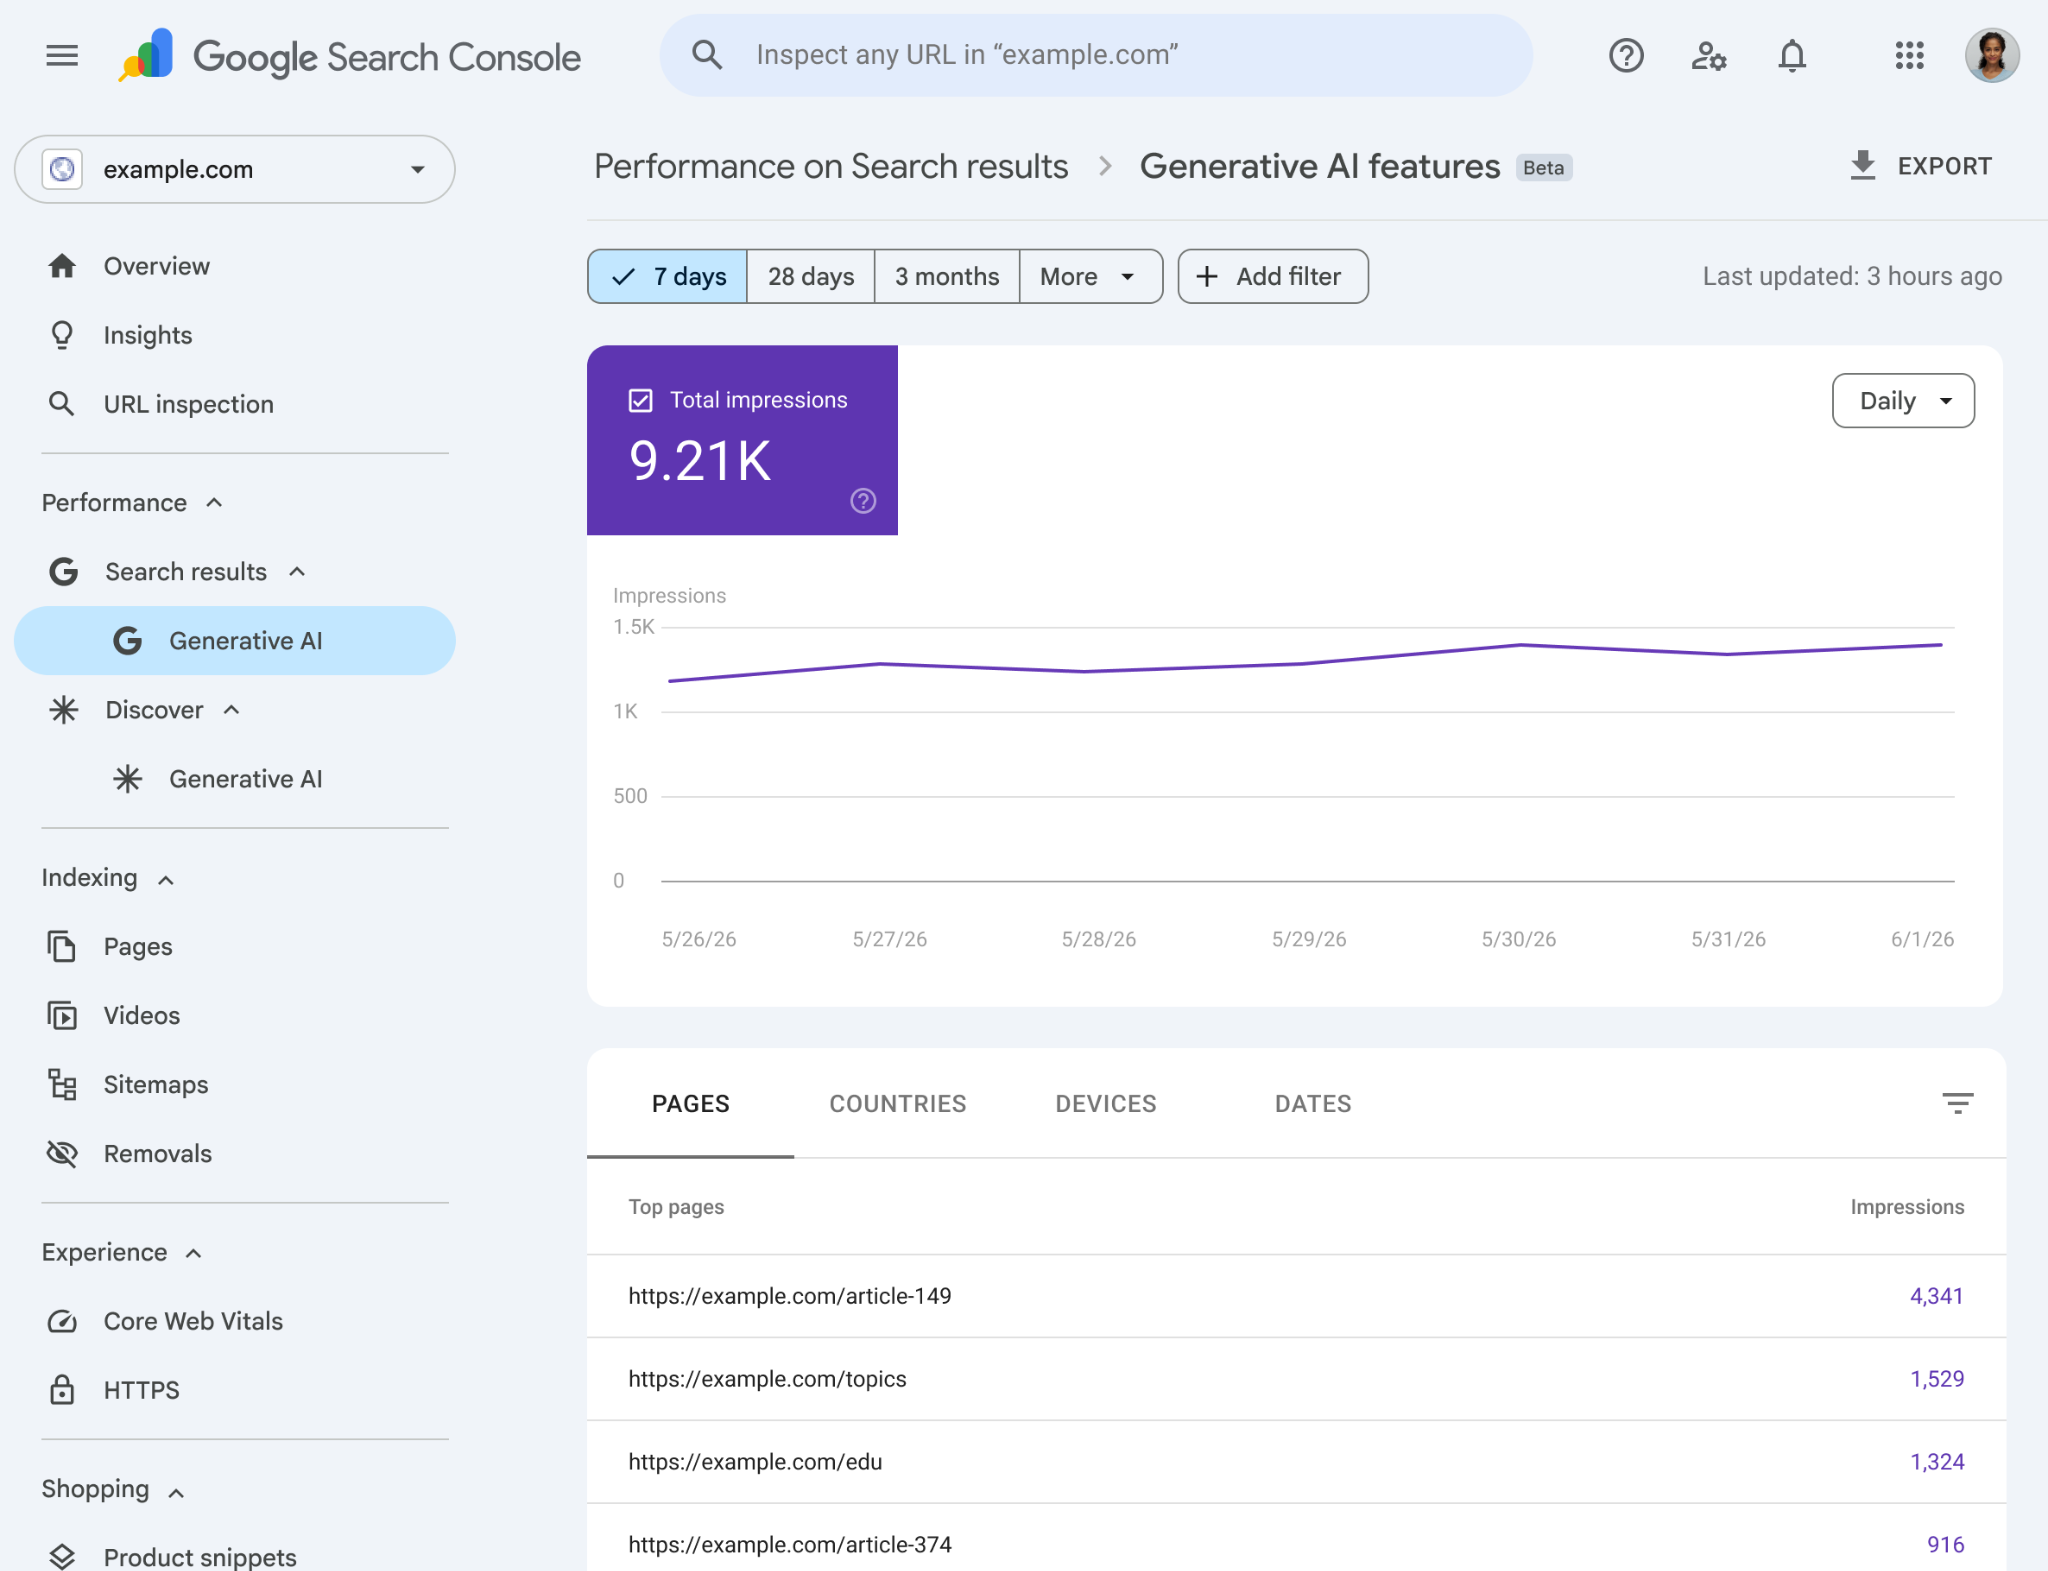
[외부 정보] Google은 2026년 6월 3일 Search Console에 생성형 AI 성과 보고서를 공개했습니다. 일부 사이트를 대상으로 한 롤아웃이며, AI Overviews와 AI Mode 같은 기능에서 URL이 보인 횟수, 노출된 페이지, 국가, 기기, 날짜를 확인할 수 있습니다. Google의 공식 가이드도 생성형 AI 검색을 기존 검색의 기반 위에 놓인 경험으로 설명하며, 생성형 AI 성과 보고서로 가시성을 확인하라고 안내합니다.
다만 이 데이터가 AI 검색 전체를 덮지는 않습니다. Google의 퍼스트파티 데이터는 Google 표면의 기준선으로 쓰고, ChatGPT·Claude·Perplexity처럼 별도의 응답 환경은 별도 추적해야 합니다. Search Console 숫자를 “AI 검색 전체의 점유율”로 읽는 순간, 정확한 데이터가 오히려 잘못된 확신을 만듭니다. 한 엔진의 관측값과 여러 엔진에서의 실험 결과를 분리해 보관해야 합니다.
내 결론은 간단하다: 보고서를 실험 노트로 바꿔라
AI 검색에서 “잘 보인다”는 말은 출발점이지 성과의 결론이 아닙니다. 더 좋은 질문은 “어떤 질문에서, 어떤 URL이, 어떤 변경 때문에, 대조군보다 더 자주 인용됐는가”입니다. 이 질문을 문서에 적는 순간 콘텐츠 팀의 업무도 달라집니다. 새 도구를 더 사는 대신, 프롬프트 세트와 페이지 매핑을 정리하고, 한 가설씩 바꾸고, 되돌림을 기다리게 됩니다.
이번 주에 페이지 하나와 핵심 질문 10개만 고르세요. 비슷한 페이지를 대조군으로 남기고, Search Console에서 확인 가능한 Google AI 노출을 기록한 뒤, 다른 엔진에서는 같은 질문을 같은 날짜에 점검하세요. 그리고 다음 회의에는 “가시성이 올랐다”가 아니라 “이 변경을 유지할지 말지”를 결정할 표를 가져가세요. 실험 결과가 예상과 달랐다면 댓글로 공유해 주세요. AI 검색에서 가장 값진 데이터는 성공담보다 다음 추측을 없애는 실패 기록일 수 있습니다.
근거 출처
외부 정보 (하베스터 수집)
- Heather Campbell, “AI Search is Working. How to Prove It With Real Tests.” — Search Engine Journal (2026-07-23). seoClarity 웨비나의 골든 프롬프트, 대조군, 베이스라인·테스트 기간, 약 1,000개 프롬프트 FAQ 리버전 테스트, 메타 디스크립션·리스트 포맷 테스트를 다룬 기사. 원문 보기
- Google Search Central Blog, “Introducing Search Generative AI performance reports in Search Console” (2026-06-03). Search의 생성형 AI 기능에서 URL 노출, 페이지, 국가, 기기, 날짜를 확인하는 보고서와 일부 사이트 대상 롤아웃에 관한 공식 발표. 원문 보기
- Google Search Central, “Optimizing your website for generative AI features on Google Search.” 생성형 AI 검색에서도 기본 SEO와 사람을 위한 유용한 콘텐츠가 기반이며, Search Console 생성형 AI 성과 보고서로 가시성을 측정하라는 공식 가이드. 원문 보기
상호작용 (에이전트-드루 대화·작업)
이 글에는 필자의 독립적인 AI 검색 스플릿 테스트 실행 결과나 자체 통계가 포함되어 있지 않습니다. 실험 루프와 사례 해석은 위 외부 출처를 바탕으로 한 의견·분석이며, 실제 도입 시 각 사이트의 프롬프트와 페이지 데이터로 별도 검증해야 합니다.
작성 트리거: AI & TOOLS 큐레이션 — “AI Search is Working. How to Prove It With Real Tests” 분석. 작성 결정: 전술 소개보다 재현 가능한 실험 루프와 출처 구분을 중심으로 구성.