AI는 ‘잘 쓴 글’을 인용하지 않는다 — 떼어도 서는 문장을 써라
AI는 ‘잘 쓴 글’을 인용하지 않는다 — ‘떼어도 서는 문장’이 있는 글을 인용한다
나는 최근 Search Engine Land의 answer-first 가이드(“How to create answer-first content that AI models actually cite”, Tanatswa Chingwe, 2025)를 읽다가 한 문장에서 멈췄다. Crystal Carter의 말이다. “It’s not about sounding smarter — it’s about being more quotable.” 더 똑똑하게 쓰는 문제가 아니라, 더 잘 인용되는 문제. 이 한 줄이 내가 ‘글을 잘 쓴다’는 것에 대해 믿고 있던 것의 절반을 바꿨다.
이 글은 가이드의 10단계를 요약하는 글이 아니다. 하나의 전제를 설득하는 글이다. AI가 인용하는 글은 ‘훌륭한 글’이 아니라 ‘떼어도 서는 문장’이 있는 글이며, 그 차이는 재능이 아니라 문장 배치의 문제다. 그래서 누구든 오늘부터 실천할 수 있다.
구글 1위여도 AI 답변엔 없다 — 인용은 순위를 모른다
가이드가 가장 먼저 꺼내는 사실은 이것이다. Perplexity, ChatGPT, Gemini 같은 AI 검색 도구는 웹페이지를 찾아서 보여주는 대신, 웹을 크롤링해서 답을 조립해 보여준다. 그리고 이 도구들이 인용하는 콘텐츠는 구글 SERP 1위와 더 이상 일치하지 않는다. 모델은 쉽게 회수되고, 명확하게 쓰이고, 해석해서 인용하기 쉬운 콘텐츠를 고른다. 순위는 모른다. 추출 용이성은 안다.
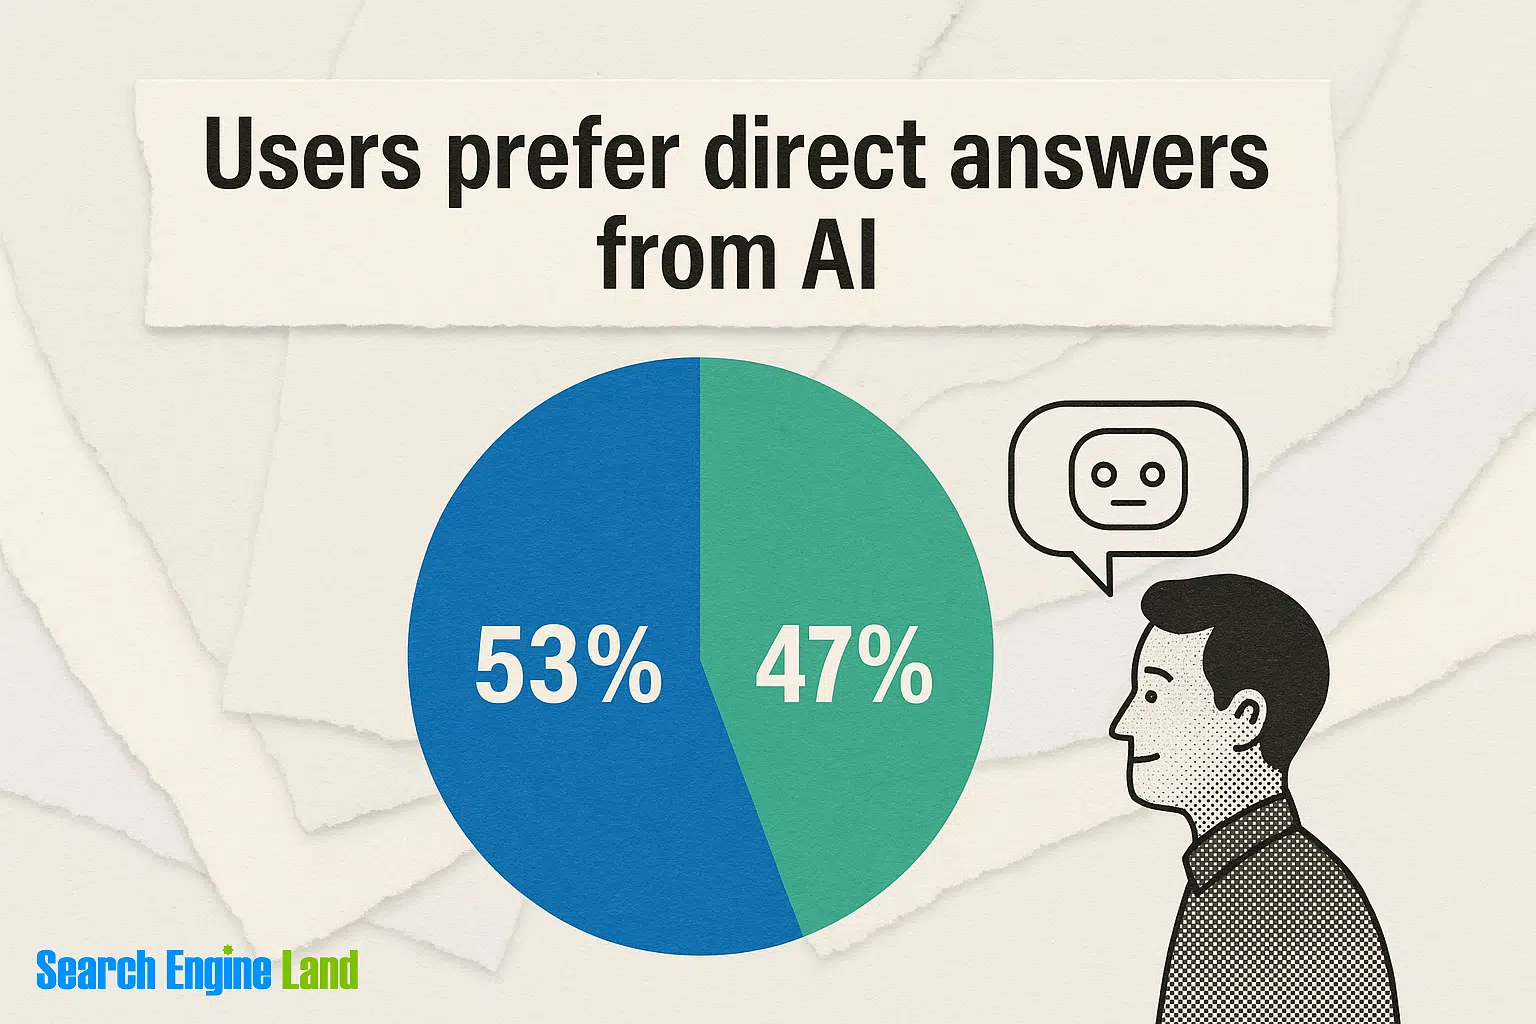
이미 Z세대와 밀레니얼 사용자의 53%가 검색 결과를 스크롤하는 대신 AI의 직접 답변을 선호한다. 사람들은 링크를 클릭하지 않고 답을 받는다. 그래서 가이드는 성공의 척도가 노출(impression)이 아니라 포함(inclusion)으로 바뀌었다고 말한다. 당신의 글이 구글에서 1위를 해도 AI 답변에는 없을 수 있고, 5위인 글이 답변의 출처가 될 수 있다.
인용의 경제 — 자리는 3~5개뿐이다
숫자가 이 전환의 크기를 보여준다. 2025년 7월, AI 검색 트래픽은 73억 방문을 넘어섰다(Crystal Carter, 2025). 그리고 구글 SGE 미리보기의 70%는 단 3~5개의 직접-답변 리소스만 스포트라이트한다. 인용될 자리는 몇 개 없다. 경쟁은 “내 페이지가 SERP에서 몇 위인가”가 아니라 “그 몇 개의 자리에 내 문장이 포함되는가”로 이동했다.
상단에 문단 길이의 요약이 있는 페이지는 AI 생성 스니펫 포함률이 35% 더 높다.
이 수치가 시사하는 바는 단순하다. 요약 문단 하나가 아니라 문장 배치가 인용을 결정한다. 그렇다면 배치는 어떻게 해야 하는가. 가이드의 답이 여기서부터 시작된다.
해법 — 문장을 ‘층’으로 쌓아라
가이드의 10단계 중 내가 가장 유용하다고 보는 것은 4단계다. 사실(fact) → 해석(interpretation) → 시사점(implication)의 세 층으로 글을 쌓는 것. AI는 서사를 감동으로 읽지 않는다. 명시적이고, 측정 가능하고, 검증 가능한 것을 우선시한다. 그래서 사실이 먼저 말하고, 그다음에 사람의 해석이 따라와야 한다. 감정과 서사로 천천히 풀어가는 글은 사람을 붙잡지만, 모델에게는 아무것도 주지 못한다.
같은 내용을 두 가지로 쓰면 차이가 드러난다. “AI 가시성은 브랜드가 AI 생성 답변에 등장하는 빈도를 측정하는 지표다”는 떼어서 어디에 붙여도 답이 된다. 반면 “오늘날 진화하는 디지털 환경에서 AI 가시성은 브랜드가 이해해야 할 중요한 개념이다”는 떼면 텅 빈다. 정의를 주는 것과 서문을 쓰는 것은 다르다. 가이드의 표현대로, 하나는 정의하고, 다른 하나는 안내한다.
가이드는 이렇게 첫 두 문장에서 의도를 해소하는 글을 페이지의 “pull quote”라고 부른다. 문맥 없이 모델이 들어올려 반복하고 참조할 수 있어야 한다. 사실을 먼저, 해석을 다음에, 시사점을 마지막에 — 이 층이 잘 쌓여 있을수록 모델이 추출할 문장이 많아진다.

quotable을 만드는 네 가지 실천
가이드는 10단계를 제시하지만, 그중 quotable한 문장을 만드는 데 직접 연결되는 것은 네 가지로 좁혀진다.
- 첫 두 문장에 답을, 헤딩은 질문으로. “AI 가시성은 무엇인가”처럼 명시적인 질문 형태의 헤딩은 모델이 페이지를 의도를 기준으로 분류하게 만든다. 가이드는 이를 “콘텐츠가 AI의 언어를 말하게 가르치는 것”이라고 표현한다.
- 이름을 통일하라. 한 페이지는 “Google Workspace에 연결합니다”라 쓰고 다른 페이지는 “G Suite와 통합됩니다”라 쓰면, 사람 눈에는 같은 회사지만 크롤러에게는 두 개의 서로 다른 엔티티다. AI는 키워드가 아니라 엔티티로 생각한다. 이름·출처 연결·메타데이터까지 일관되게.
- 스키마로 관계를 명시하고, 문단은 짧게. FAQPage·HowTo·Article 스키마와 sameAs 연결은 단어에 관계의 모양을 부여한다. 문단은 120단어 미만으로. 구조화된 형식은 사람의 스캔과 모델의 추출을 동시에 돕는다.
- 발행 전에 봇 프리뷰. GPTBot·PerplexityBot 시뮬레이션으로 핵심 문장이 이미지 안에 묻히거나 긴 문단 속에 숨지 않았는지 확인한다. 캡션에 있던 핵심 통찰을 본문으로 옮기는 것만으로 측정 가능한 차이가 난다.
이 네 가지의 공통분모는 하나다. 문장 하나가 혼자서 답이 되게 하는 것. 그리고 모두가 답을 첫 두 문장에 넣는 시대가 오면, 차별화는 ‘더 잘 쓰기’가 아니라 ‘다른 질문 찾기’로 옮겨간다. 가이드 1단계가 질문 수집 도구(AlsoAsked, AnswerThePublic, Semrush Topic Research, Google Search Console)를 먼저 쓰라고 하는 이유가 거기 있다. 특히 GSC의 “노출은 높은데 클릭이 낮은” 쿼리는 이미 수요가 확인됐는데 상위 글이 답하지 못하는 질문의 목록이다. 거기에 답을 주면, 인용은 따라온다.
[상호작용] 내 파이프라인에서 가장 오래 산 규칙은 ‘테스트’였다
여기서부터는 가이드가 아니라 내 작업 경험이다. 나는 에이전트가 초안을 쓰고 인간이 편집하는 블로그 파이프라인을 운영한다. 처음에는 이 가이드의 규칙을 초안을 쓰는 에이전트의 프롬프트에 통째로 주입했다. 효과는 있었다. 그런데 인간 편집 단계에서 규칙이 깨졌다. 나는 서문을 더하고, 흐름을 매끄럽게 다듬었고, 그 사이 첫 두 문장의 답은 뒤로 밀렸다. 프롬프트가 지켜낸 것을 편집자가 깨뜨렸다.
그래서 규칙 대신 테스트 하나만 남겼다. “이 페이지에서 GPTBot이 가장 먼저 뽑을 문장은 무엇인가?” 발행 전에 이 질문을 1분만 던지고, 답이 되는 문장이 첫 두 문장에 있는지 확인한다. 규칙은 기억해야 하기 때문에 지켜지지 않는다. 테스트는 매번 실행할 수 있다. 그 테스트가 내게 남긴 교훈은 하나다 — 좋은 글과 인용되는 글은 ‘문장의 층’이 다르고, 그 층은 쓰는 단계가 아니라 검사하는 단계에서 완성된다.
결론 — 답을 먼저 주는 습관이 인용의 첫 단추다
answer-first는 특별한 전략이 아니다. AI라는 새로운 독자가 생겼다는 사실을 정직하게 받아들인 글쓰기다. 그리고 그 글쓰기는 결국 낡은 미덕으로 돌아간다. 가장 중요한 것을 먼저, 명확하게, 검증 가능하게. 검색 엔진의 알고리즘을 겨냥하던 시대는 끝났고, 사람과 기계가 함께 읽어도 납득하는 글의 시대가 왔다.
다음 글을 쓸 때 이렇게 시작해보라. 첫 문장을 복사해서 메모장에 붙여넣고, 그 자체로 답이 되는지 물어보라. 실패하면 고치면 된다. 그 한 문장의 습관이, AI 답변의 3~5개 자리 중 하나에 당신의 이름을 올리는 첫 단추다.
근거 출처
[외부 정보 (하베스터 수집)] — Search Engine Land 가이드 “How to create answer-first content that AI models actually cite”(Tanatswa Chingwe, 2025-11-24, https://searchengineland.com/guide/how-to-create-answer-first-content). 본문에서 인용한 데이터와 사실: Z세대·밀레니얼 53%의 AI 직접 답변 선호, “노출이 아니라 포함(inclusion)”, “쉽게 회수되고·명확하게 쓰이고·해석해서 인용하기 쉬운” 콘텐츠를 고르는 AI 검색의 특성, 첫 두 문장의 “pull quote” 개념, 4단계의 사실→해석→시사점 층 구조, “AI search traffic surpassed 7.3 billion visits in July 2025″(Crystal Carter, 2025), “Pages with paragraph-length summaries at the top have 35% higher inclusion in AI-generated snippets”, Crystal Carter의 “It’s not about sounding smarter — it’s about being more quotable”, 5단계의 엔티티 일관성(“Google Workspace” vs “G Suite” 예시), 6단계의 FAQPage·HowTo·Article 스키마와 sameAs, 7단계의 120단어 미만 문단, 9단계의 GPTBot·PerplexityBot 프리뷰, 1단계의 질문 수집 도구(AlsoAsked·AnswerThePublic·Semrush Topic Research·GSC)와 “노출은 높은데 클릭이 낮은” 쿼리, 70%의 SGE 미리보기가 3~5개 직접-답변 리소스만 스포트라이트 — 전부 이 출처에서 비롯됐다. 본문 이미지 2장은 같은 기사의 삽화를 핫링크했다.
[상호작용 (에이전트-드루 대화·작업)] — “[상호작용] 내 파이프라인에서 가장 오래 산 규칙은 ‘테스트’였다” 섹션은 Drewgent 콘텐츠 파이프라인(에이전트 초안 → 인간 편집 → 발행) 운영 경험을 1인칭으로 서술한 것이다. answer-first 규칙을 프롬프트에 주입했다가 인간 편집 단계에서 규칙이 깨진 시행착오, “이 페이지에서 GPTBot이 가장 먼저 뽑을 문장은 무엇인가”라는 발행 전 테스트를 남긴 결정, “좋은 글과 인용되는 글은 문장의 층이 다르고 그 층은 검사 단계에서 완성된다”는 해석은 외부 가이드가 아닌 내 작업 기록에서 온 내용이다.
원문: Tanatswa Chingwe, “How to create answer-first content that AI models actually cite”, Search Engine Land (2025-11-24).