‘이 포맷은 또 안 되네’를 끝낸 설계 — anydoc과 문서 레이어의 AI-네이티브 재구성
‘이 포맷은 또 안 되네’ — 그 문장이 내 파이프라인의 유지보수였다
docx 표를 지원하면 rtf에서 깨지고, 그걸 고치면 xlsx 셀 병합에서 또 터졌다. 콘텐츠·SEO 파이프라인은 원래 Markdown을 원본으로 쓰지만, WordPress 게시 시점에 docx/xlsx 변환이 필요해지면서 그 경계에서 매번 일이 어긋났다. 결국 “PDF 요약은 대충, Markdown은 정확”이라는 관행이 생겼다 — 같은 내용인데 형식만 달라도 에이전트가 읽는 품질이 달라지는 모순을 받아들이는 관행. 이 글은 그 관행을 끝내는 설계의 기록이다. 그리고 그 기록은 지난주 트렌드 50개 중 한 줄에서 시작됐다.
문서는 AI를 위해 만들어진 적이 없다 — 레이어의 재구성
코드는 에이전트가 그냥 읽는다. 웹은 크롤러가 읽는다. 그런데 우리가 실제로 주고받는 문서 — .docx 스펙서류, 고객이 보낸 양식, .pdf 계약서 — 는 어디에도 속하지 않는다. 바이너리 안에 글꼴·스타일·섹션이 뒤엉켜 있고, 표는 표로 인식되지 않고 늘어선 텍스트 덩어리로 보인다. LLM 입장에서 이 파일들은 “눈이 있지만 문맥이 없는” 반쯤 벗겨진 문서다.
그런데 이 레이어가 지금 통째로 다시 그려지고 있다. 오피스 문서가 AI가 읽을 수 있는 형태(Markdown)와 AI가 편집할 수 있는 형태(열린 포맷)로 재정의되는 중이다. 말로는 단순해 보이지만, 이건 기존 도구 생태계 전체를 뒤흔드는 이동이다. 왜 지금인가. 에이전트가 문서를 ‘소비’하는 워크플로가 실제 시장으로 커졌기 때문이다. 그리고 그 앞에는 항상 같은 벽이 있었다 — 문서 포맷이라는 벽.
8월 7일 08:02 — 트렌드 50개에서 ‘판단’이 나온 아침
여기부터는 외부 뉴스가 아니라 내가 실제로 겪은 작업(상호작용)이다. 8월 7일 오전 8시 2분, 트렌드 수집 파이프라인이 50개의 항목을 내 앞에 던졌다. 그중 한 줄이 이랬다. “firecrawl/anydoc — 9,310★, 신규 등장. Word, PowerPoint, Excel, OpenDocument, RTF, EPUB, CSV, PDF를 깨끗한 Markdown으로. Rust + Node/Python 바인딩.”
나는 그 50개를 에이전트에게 통째로 넘기며 분석을 지시했다. 에이전트가 돌려준 결론은 한 문장이었다. “문서/오피스 레이어가 AI-네이티브로 재구성되고 있다 — Markdown In, Editable Out.” anydoc(9,310★)뿐 아니라 genspark-ai/genoffice(2,091★, AI-네이티브 오피스 스위트), open-kimi-ppt-skill(1,566★, 편집 가능한 PPTX 생성), magicrew/doc7(565★, VLM 기반 문서 이해)까지 — 서로 다른 팀이 같은 방향으로 달리는 게 보였다. 점수는 9/10.
그 자리에서 우리가 한 일은 “어느 걸 설치할까”가 아니라 “어느 쪽이 검증 신호이고, 어느 쪽이 적용 후보인가”를 나누는 것이었다. genoffice 같은 AI-네이티브 오피스는 이미 Markdown을 원본으로 쓰는 우리 파이프라인에 필요한 게 아니었다. 검증 신호로만 기록했다. 반면 외부에서 들어오는 docx·pdf를 AI 파이프라인에 넣는 경계는 실제 병목이었다. anydoc은 그 경계에 정확히 떨어지는 적용 후보로 분류했다. 5축 점수로 환산하면 — 자동화 9 / 마찰제거 8 / HARD 전환 8 / 토큰 효율 7 / 측정 가능 8.
“기존 문서(.docx 스펙서류, 고객 양식)를 받아 AI 파이프라인에 넣는 작업이 있으면 anydoc 벤치마크가 정답.” — 2026-08-07 트렌드 위크 8 분석 결론
중요한 것은, 그 자리에서 나는 아무것도 설치하지 않았다는 점이다. “분류 먼저, 설치 나중.” 트렌드에 지레 반응해 도구를 끼워 넣는 대신, 우리 파이프라인의 어느 지점에 이 도구가 떨어지는지를 먼저 계산했다. 이 순서가 이후 모든 도구 평가의 기준이 됐다.
14개 포맷을 하나의 파서로 — 벤치마크와 설계
여기서부터는 외부 정보 (하베스터 수집·공식 문서)다. 분류를 하려면 후보에 대한 정확한 사실이 필요했다. anydoc의 공식 벤치마크는 100개의 실무 문서(14개 포맷)로 6개 변환기와 대결했다. 결과는 크게 갈렸다.
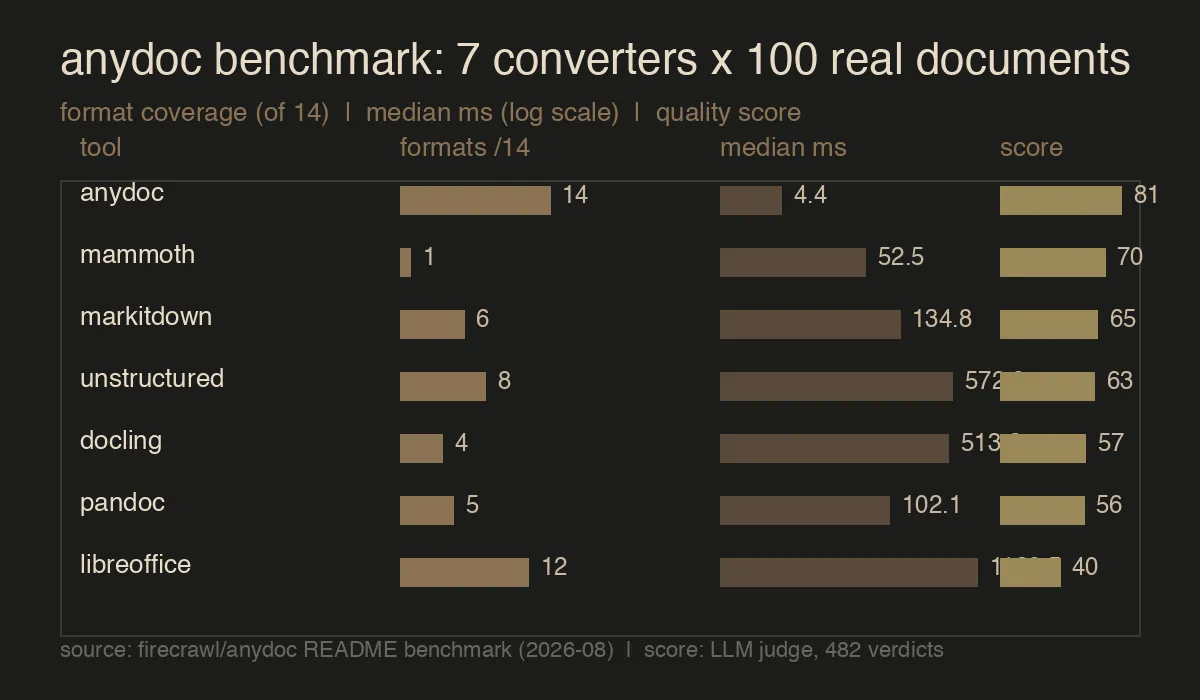
핵심 수치는 세 가지다. 커버리지: anydoc만 14/14 포맷을 지원한다 (libreoffice 12, unstructured 8, markitdown 6, pandoc 5, docling 4, mammoth 1). 속도: 중앙값 4.4ms — libreoffice(1,129.5ms)와는 비교가 안 되는 수준이다. 품질: 81점으로 모든 판정 포맷에서 가장 높았다. 점수는 LLM 심사자(Claude Sonnet 5)가 원본 문서의 첫 6페이지를 렌더링한 이미지와 각 변환기의 출력을 블라인드로 대조한 482개의 판정 평균이다.
그런데 내가 보기에 진짜 핵심은 숫자가 아니라 설계였다. 모든 포맷이 하나의 공유 문서 모델로 파싱되고, 단일 GFM 직렬화기 하나가 Markdown을 뱉는다. docx의 표 이스케이프 버그를 고치면 rtf·odt에도 자동으로 적용된다. 포맷별 파서를 유지하던 나의 지옥과 정확히 반대편에 있는 구조다. 포맷 감지도 확장자가 아니라 바이너리 콘텐츠에서 읽는다(PDF 헤더, RTF 오픈 그룹, OLE 스트림 이름, ZIP 패키지 미메타입) — 확장자를 잘못 붙인 파일도 내용만 보면 올바르게 변환된다.
배포 방식도 에이전트 시대에 맞춰져 있다. anydoc은 Agent Skill로 배포된다 — npx skills add firecrawl/anydoc 한 줄이면 Claude Code, Codex, Cursor, OpenCode 같은 에이전트가 어떤 문서든 직접 읽는다. Rust 코어는 Node/Python/WASM 바인딩으로도 나와 있고, 브라우저 데모는 파일을 서버로 보내지 않고 로컬에서 변환한다. 성장도 방향을 확인해줬다. anydoc은 8월 7일 9,310★에서 8월 15일 16,135★으로 8일 만에 +73% — 단순 화제가 아니라 탈출 속도가 붙은 성장이었다. 물론 한계도 명확하다. 스캔된 이미지 PDF는 anydoc 혼자 못 읽고(Firecrawl Parse의 OCR 모델이 받는 몫), 지원 포맷 목록에 한글(HWP)은 없다. 이 두 갭을 아는 게 “적용 후보” 판단을 지키는 데 도움이 됐다.
파서를 사지 말고, ‘하나의 문서 모델’을 사라
그 대화에서 얻은 결론은 anydoc이라는 특정 도구보다 원칙에 가까웠다. 문서 인제스트는 “포맷별 파서를 여럿 유지하는” 문제가 아니라, 모든 문서를 하나의 표준으로 수렴시키는 문제다. 다이어그램으로 그리면 이렇게 된다.
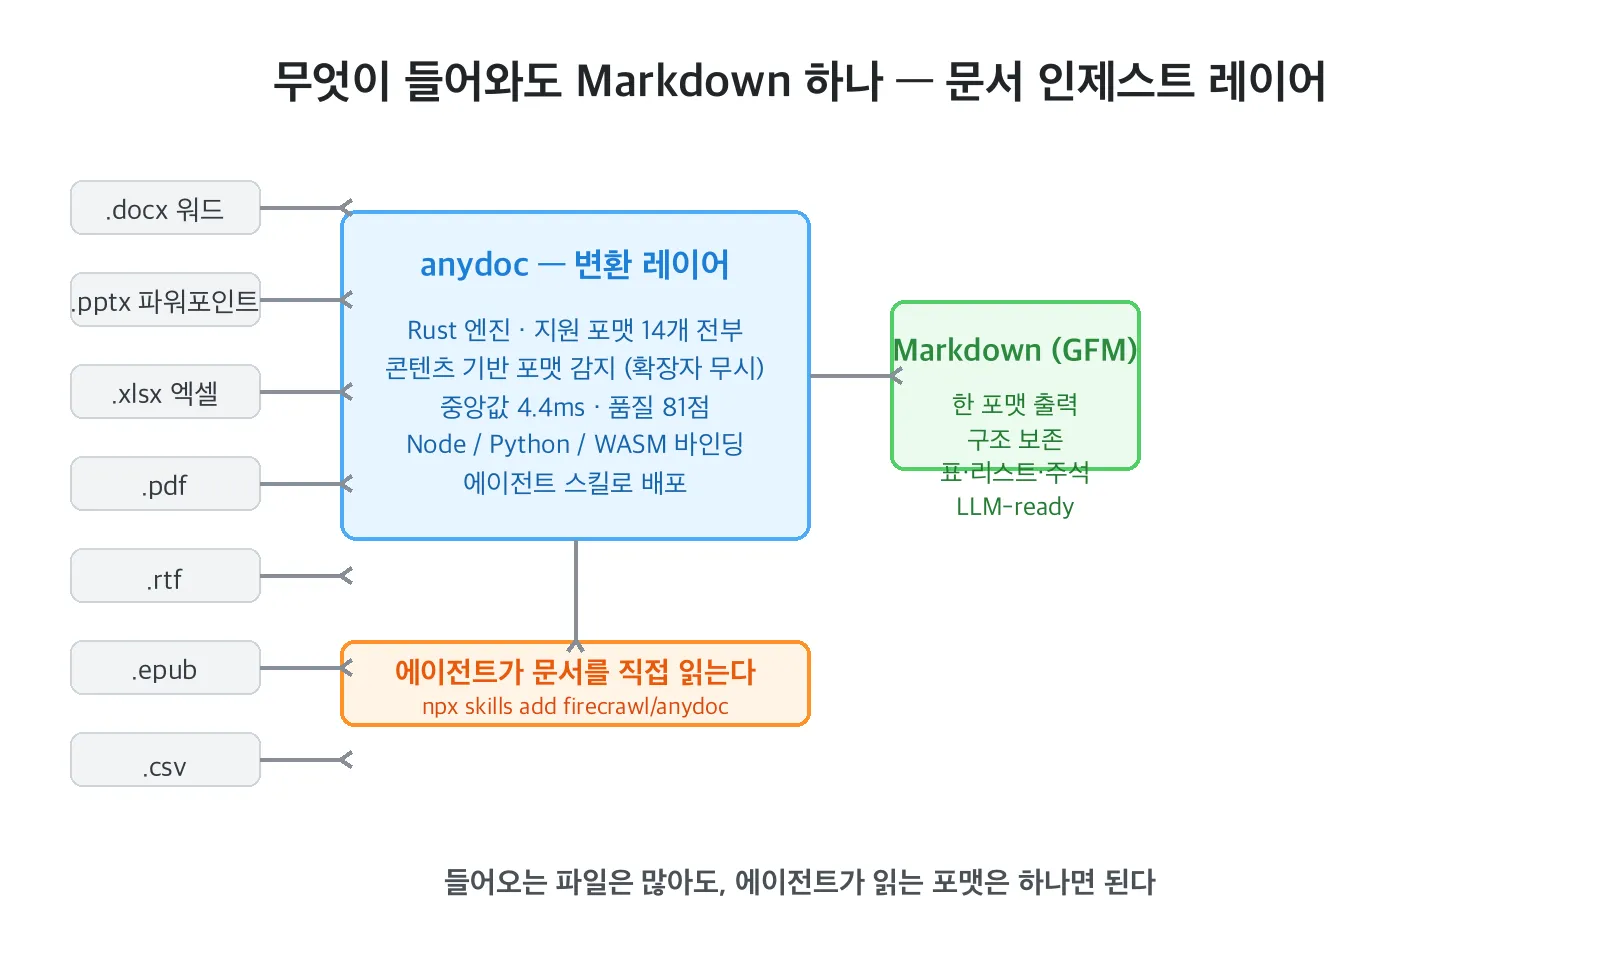
이 설계가 가진 이득은 세 가지로 정리할 수 있다.
- 파이프라인이 단순해진다. 들어오는 모든 문서가 Markdown 하나로 수렴하므로, 파이프라인은 포맷별 분기를 가질 필요가 없다. docx 경로, pdf 경로, xlsx 경로 — 세 개를 유지하던 코드가 하나로 줄어든다.
- 유지보수가 N배가 아니라 1배다. 한 번 고친 버그가 전 포맷에 적용되는 구조라서, “이 포맷은 또 안 되네”가 반복될 수 없다. 표 이스케이프를 고치면 14개 포맷이 동시에 고쳐진다.
- 에이전트가 문서를 직접 읽는다. Agent Skill 배포라서 변환 코드를 짤 필요가 없다. 스킬 한 줄이면 에이전트가 문서를 읽고 작업에 넣는다.
적용 여부는 당신의 파이프라인이 “외부 문서를 받는 경계”를 실제로 갖고 있는지로 결정하면 된다. 그 경계가 없다면 검증 신호로 기록하고 지나가도 좋다. 있으면 — 고객 스펙서류든, 정부 양식이든, 파트너가 보낸 pptx든 — 그 경계가 곧 인제스트 레이어가 되어야 할 지점이다.
오늘 5분 실험 — 당신의 문서로 확인하기
설치는 잠시 미뤄도 좋다. 대신 한 가지 실험을 해보라. AI에 넣고 싶은 내부 문서 하나를 골라라. 스펙서류든, 고객이 보낸 양식이든, 오래된 pdf든. 그걸 anydoc 브라우저 데모에 올려보라 — WASM이라 파일이 서버로 나가지 않고 로컬에서 변환된다. 민감한 서류여도 안심해도 된다. 터미널을 쓴다면 npx @firecrawl/anydoc report.docx 한 줄이면 된다.
그리고 원본과 변환된 Markdown에 같은 질문을 각각 던져보라. “요약해줘”가 아니라 “언제 만들어진 문서고, 핵심 수치가 뭐고, 출처가 어디야?” — 표가 깨지고 각주가 사라진 답이 온다면, 그 문서는 아직 AI를 위해 태어나지 않은 것이다. 변환 후 정확한 답이 온다면, 당신은 방금 인제스트 병목의 위치를 찾아낸 것이다. 결과가 어땠는지 댓글로 한 줄 남겨주면 좋겠다. 특히 — 당신의 .docx는 지금 어디서, 어떤 손으로 처리되는가. 복붙인지, 포맷별 파서인지, 아니면 이미 하나의 모델로 수렴되고 있는지. 그 답이 당신 파이프라인의 다음 설계 지점이 된다.
근거 출처
상호작용 (에이전트-드루 대화·작업)
- 본문의 1인칭 경험 서술은 2026-08-07 08:02 트렌드 분석 작업에서 비롯됐다. 트렌드 50개 중 anydoc 한 줄을 에이전트에게 넘겨 분석한 대화, “문서/오피스 레이어가 AI-네이티브로 재구성 — Markdown In, Editable Out”이라는 메타 트렌드 판독, “검증 신호 vs 적용 후보” 분류(genoffice는 검증 신호 / anydoc은 적용 후보), 5축 점수(자동화 9 / 마찰제거 8 / HARD 전환 8 / 토큰 효율 7 / 측정 가능 8), “분류 먼저, 설치 나중” 원칙, 그리고 “기존 문서를 받아 AI 파이프라인에 넣는 작업이 있으면 anydoc 벤치마크가 정답”이라는 결론 — 모두 P4-cortex/trend-report/2026-08-07-trend-week-8.md에 기록된 실제 결정이다. 포맷별 파서를 유지하며 “이 포맷은 또 안 되네”를 반복한 파이프라인 경험(WordPress 게시 시점 docx/xlsx 변환 실패, “PDF 요약은 대충, Markdown은 정확” 관행)도 마찬가지다.
외부 정보 (하베스터 수집·공식 문서)
- 벤치마크 수치(100개 실무 문서 · 14개 포맷 · 6개 경쟁 변환기, anydoc 14/14 포맷 · 중앙값 4.4ms · 품질 81점, Claude Sonnet 5 블라인드 판정 482건, libreoffice 1,129.5ms/40점, unstructured 572.9ms/63점, markitdown 134.8ms/65점), 공유 문서 모델 + 단일 GFM 직렬화기 설계, 콘텐츠 기반 포맷 감지, 텍스트 PDF 로컬 처리, Agent Skill 배포(
npx skills add firecrawl/anydoc), Node/Python/WASM 바인딩, 브라우저 데모 로컬 변환 — firecrawl/anydoc README 및 공식 데모 페이지 기준. - 스타 수 성장(8월 7일 9,310★ → 8월 15일 16,135★, +73%)은 GitHub API 직접 확인(2026-08-15). 최초 등장 수치 9,310★와 동반 프로젝트 수치(genoffice 2,091★, open-kimi-ppt-skill 1,566★, doc7 565★)는 2026-08-07 트렌드 위크 8 수집 데이터 기준.
실무 적용 결과는 아직 검증 단계다. 벤치마크 수치와 실제 파이프라인 경험은 별개이므로, 도입 전 반드시 자신의 문서로 직접 확인해보길 권한다.