AI 검색용으로 다시 썼는데, 인용은 0/10이었다 — 규칙을 게이트로 바꾼 빌드 로그
AI 검색용으로 다시 썼는데, 인용은 0/10이었다
AI Overviews와 생성형 검색에 맞춰 글을 다시 썼다. 질문형 H2를 넣고, 문단을 짧게 자르고, FAQ까지 붙였다. 그런데 첫 전체 점검에서 humanerd.kr이 AI 답변에 인용된 횟수는 0/10이었다.
처음에는 콘텐츠 구조가 부족하다고 생각했다. 하지만 빌드 로그를 다시 열어보니 문제는 다른 곳에 있었다. 우리는 “좋은 구조를 쓰자”는 규칙은 갖고 있었지만, 그 규칙이 실제 발행·측정 파이프라인을 통과했는지 확인하는 게이트는 갖고 있지 않았다. 이 글은 AI 검색 최적화 팁을 더 나열하는 글이 아니다. 그 팁을 프로젝트에 옮길 때 같은 실수를 반복하지 않도록, 규칙을 시스템으로 바꾼 과정을 기록한다.
[외부 정보] GEO의 핵심은 더 많이 쓰는 것이 아니라, 인용될 답을 만드는 것이다
SEOPress의 Benjamin Denis가 쓴 How to Optimize Content for AI Overviews and Generative Search는 생성형 엔진 최적화(GEO)를 Google AI Overviews, ChatGPT, Perplexity처럼 링크 목록 대신 답을 만드는 검색 경험에 맞춰 콘텐츠를 다듬는 작업으로 설명한다.
전통적인 SEO의 목표가 검색 결과에서 순위를 얻고 클릭을 받는 것이었다면, GEO의 목표는 AI가 만든 답변 안에 콘텐츠가 포함되거나 출처로 인용되는 것이다. 검색어를 한 번 포함시키는 문제가 아니라, 사용자의 질문을 이해하고 그 질문에 대한 인용 가능한 답을 만드는 문제로 바뀐다.
이 가이드는 실행 순서를 다섯 단계로 제시한다. 키워드 대신 실제 대화형 질문을 조사하고, 전문가 인용·최신 통계·원천 데이터를 넣고, AI가 추출하기 쉬운 구조를 만들고, Article·FAQPage 스키마와 사이트 성능을 정비한 뒤, 고정된 “AI 순위”가 없다는 전제에서 인용 변화를 계속 관찰하는 방식이다.
- 프롬프트 리서치: People Also Ask, Reddit, Quora, 포럼에서 실제 질문을 찾는다.
- 인용 가치: 전문가 의견, 최신 통계, 신뢰할 수 있는 원문과 독자적인 데이터를 연결한다.
- 추출 가능한 구조: 역피라미드, 질문형 헤딩, 번호 목록, 2~4문장 문단, FAQ를 사용한다.
- 기술 기반: Article·FAQPage 스키마, 모바일 성능, 내부 링크를 점검한다.
- 모니터링: 고정된 AI 순위 대신 프롬프트별 인용 추세를 기록한다.
가이드가 특히 강조하는 실패 지점은 세 번째다. 좋은 페이지라도 AI가 쉽게 파싱하고 꺼내 쓰지 못하면 생성형 검색에서 보이지 않을 수 있다. 그래서 섹션 첫머리에 답을 놓고, “시작하기”처럼 모호한 제목 대신 “프롬프트 리서치에는 어떤 도구가 필요한가?”처럼 질문을 제목으로 쓰라고 권한다.
다만 이 외부 가이드는 구조를 잘 만드는 방법을 말하지, 구조가 실제 시스템 안에서 끝까지 살아남는 방법까지는 다루지 않는다. 바로 그 빈틈에서 우리의 0/10이 나왔다.
[상호작용] 우리가 먼저 고친 것은 글이 아니라 측정 루프였다
여기서부터는 하베스터가 수집한 외부 정보가 아니라, humanerd.kr에서 실제로 진행한 작업과 그 로그다. 가이드의 다섯 단계를 읽은 뒤 우리는 1단계와 5단계를 먼저 시스템으로 만들었다. 이유는 단순했다. 구조가 나쁜 것인지, 사이트 권위가 부족한 것인지 측정하지 않은 채 글만 고치면 다음 작업의 근거가 사라지기 때문이다.
질문 풀은 일반 키워드 도구에서 복사하지 않았다. drew-db에 쌓인 실질문, 코칭 문의, 커뮤니티에서 반복된 질문을 바탕으로 10개를 만들었다. “AI 에이전트가 뭐예요?”, “MCP가 뭔가요?”, “에이전트가 요청한 권한을 승인해도 되나요?”처럼 실제 사람이 막히는 문장을 콘텐츠 한 편과 연결했다. 각 글은 질문형 제목, 첫 문단의 직접 답, 상세 설명, FAQ로 구성했다.
그다음 ai_citation_check.py를 만들었다. 주간 실행에서는 ROLLING 질문 3개를, 월간 전체 점검에서는 FULL 질문 10개를 사용한다. 각 질문을 웹 검색이 가능한 AI API에 넣고 답변에 포함된 URL을 수집한 뒤, URL에 humanerd.kr이 들어 있는지를 판정한다. 결과는 reports/ai-citation/YYYY-MM-DD.md에 저장하고, 미인용 질문이 있으면 exit 1로 끝내 크론 알림이 발생하게 했다.
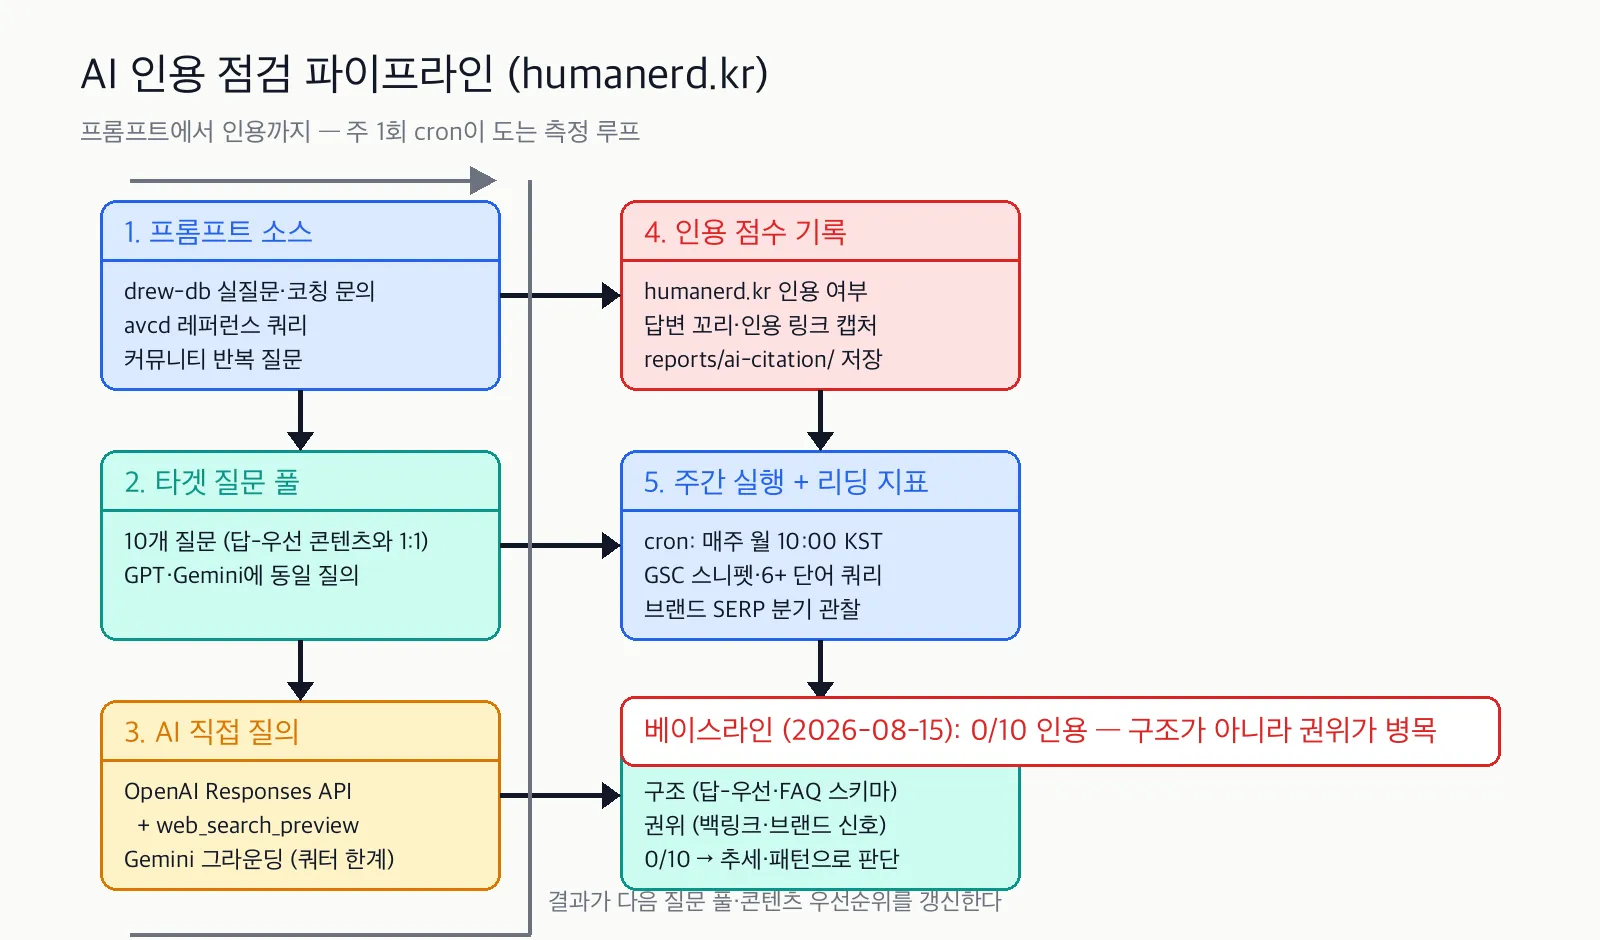
첫 풀 스윕의 결과가 0/10이었다. 이 숫자는 콘텐츠가 쓸모없다는 뜻이 아니었다. 같은 시기 GSC에는 클릭 0, 노출 6, 평균 포지션 21.3이 찍혔고 의미 있는 쿼리 매칭은 없었다. 홈은 인덱싱돼 있었지만 브랜드 신호와 권위가 부족했다. 즉 구조는 추출 가능성을 높이지만, 신뢰를 자동으로 만들어주지는 않는다는 결론을 얻었다.
사람이 지키는 규칙은 왜 발행 순간에 사라지는가
우리 콘텐츠 파이프라인은 schedule → write → publish 세 모드로 움직인다. 작성 에이전트는 Gutenberg HTML을 초안 파일에 쓰고, 발행 단계가 제목·커버·WordPress 업로드를 처리한다. 이 구조에서 “질문형 H2를 써라”는 문장은 작성자의 기억에만 남아 있으면 쉽게 무너진다. 반면 첫 H2를 제목으로 파싱하거나, 로컬 커버 경로를 미디어 업로드 경로로 변환하는 동작은 시스템이 실제로 사용하므로 계약이 된다.
빈 본문 사고도 같은 원리였다. 발행 경로가 임시 파일을 잘못 참조하면서 본문 1바이트짜리 글이 만들어졌다. 질문형 H2와 FAQ를 아무리 잘 설계해도 본문이 비어 있으면 구조는 존재하지 않는다. 그래서 “본문이 있어야 한다”는 안내를 남기는 대신, 빈 HTML이면 발행을 중단하는 fail-closed 조건을 발행 함수 앞단에 두었다.
작성 시간도 구조 품질의 일부였다. 작성기 타임아웃이 600초일 때 9건 중 8건이 정확히 제한 시간에 실패했다. 구조를 지킬 시간이 없으면 에이전트는 질문형 헤딩과 짧은 문단부터 생략한다. 타임아웃을 900초로 늘리고, 초안 회수 경로와 회당 write 배치 상한 10건, WIP 상한 5, 일일 발행 상한 3을 두었다. 이것은 SEO 규칙이 아니라, SEO 규칙이 지켜질 수 있게 하는 자원 예산이다.
| 작성 지침 | 규칙으로만 둘 때 | 게이트로 바꾼 뒤 |
|---|---|---|
| 본문이 있어야 한다 | 빈 글도 다음 단계로 진행 | 빈 HTML이면 발행 중단 |
| 질문형 H2 | 편집 중 일반 제목으로 회귀 | 첫 H2를 제목 파서가 실제로 사용 |
| 구조를 지킬 시간 | 타임아웃 직전에 구조 생략 | 900초·초안 회수·배치/WIP 상한 |
| 인용 모니터링 | “나중에 확인”으로 미룸 | 주간 크론·리포트·미인용 시 exit 1 |
당신의 프로젝트에 옮길 때는 이 순서를 뒤집어라
외부 가이드의 5단계를 그대로 체크리스트로 옮기면 구조부터 고치기 쉽다. 우리의 빌드 로그가 보여준 더 안전한 순서는 측정 → 발행 검증 → 구조 → 권위 확장이다. 결과를 먼저 볼 수 있어야 다음 수정이 추측이 아니라 진단이 된다.
- 질문 3개를 고정하라. 고객 문의, 지원 티켓, 커뮤니티 로그에서 실제 질문을 뽑고, 매주 같은 문장으로 AI에 질의한다. 검색량이 없어도 괜찮다. 먼저 기준선을 만들어야 한다.
- 인용 판정을 작게 자동화하라. 처음부터 복잡한 점수 모델을 만들지 말고, “내 도메인이 인용 URL에 있는가”라는 이진 판정과 날짜별 로그로 시작한다. 중요한 것은 반복이다.
- 발행 전에 실패 조건을 막아라. 빈 본문, 제목 누락, 잘못된 이미지 경로, 중복 slug처럼 결과물을 무효로 만드는 항목은 경고가 아니라 중단 조건으로 둔다.
- 그다음 답-우선 구조를 적용하라. 첫 문단에 직접 답을 두고, 질문형 H2와 번호 목록, 짧은 문단, FAQ를 사용한다. 키워드를 억지로 채우는 방식은 피한다.
- 0이 나오면 권위 병목을 확인하라. 구조를 고쳤는데도 인용이 없으면 같은 구조를 반복해서 손보지 말고, 원문 데이터·전문가 인용·저자 정보·백링크·브랜드 일관성을 점검한다.
핵심은 “AI가 좋아하는 글”을 만드는 데 있지 않다. 존재하고, 발행되고, 측정되는 글을 만드는 데 있다. 게이트가 없는 규칙은 일정이 바빠지는 순간 사라진다. 반대로 작은 게이트 하나는 다음 사고를 막고, 다음 작업의 우선순위를 로그로 돌려준다.
이번 주에는 글 하나보다 게이트 하나를 추가하라
오늘 당신의 콘텐츠 파이프라인에서 “항상 지키기로 했지만 가끔 빠지는” 규칙 하나를 고르면 된다. 빈 본문이면 중단하기, 첫 H2가 비어 있으면 실패시키기, 질문 3개를 매주 같은 조건으로 기록하기 중 하나면 충분하다. 그 규칙을 문서에 적는 데서 끝내지 말고, pass/fail로 판정되는 코드나 체크 명령으로 옮겨라.
그리고 오늘 기준선도 남겨라. 인용이 0/10이어도 괜찮다. 기준선이 있어야 8주 뒤의 1/10이 우연인지 변화인지 판단할 수 있다. 당신의 프로젝트에서 어떤 규칙을 게이트로 바꿨는지 댓글로 공유해달라. 다음 사람이 같은 실수를 피할 수 있는 가장 좋은 문서는 성공담보다 실패 조건 목록이니까.
근거 출처
외부 정보 (하베스터 수집)
- Benjamin Denis, SEOPress, “How to Optimize Content for AI Overviews and Generative Search” — GEO의 정의, SEO의 목표가 랭킹·클릭에서 AI 답변 인용으로 이동한다는 설명, 프롬프트 리서치 3단계, 전문가 인용·최신 통계의 30~40% 가시성 상승 주장, Perplexity 키워드 스터핑 실험의 -10% 결과, 역피라미드·질문형 헤딩·번호 목록·2~4문장 문단·FAQ 구조, Article·FAQPage 스키마와 모니터링 원칙을 참고했다. 하베스터 수집본은
how-to-optimize-content-for-ai-overviews-and-generative-search_202606051640.md이며 큐레이션 점수는 0.75다. - SEOPress 기사에서 인용한 Gartner의 2026년 전통 검색엔진 볼륨 25% 감소 전망 — 외부 전망으로만 사용했으며, humanerd.kr의 실측값으로 서술하지 않았다.
상호작용 (에이전트-드루 대화·작업)
P4-cortex/scripts/content_orchestrator.py의 3-mode 파이프라인(schedule → write → publish), 첫 H2 제목 추출, 작성 타임아웃 900초, WRITE_BATCH_CAP 10, WIP_LIMIT 5, 일일 발행 상한 3은 실제 코드에서 확인한 운영 구조다.reports/humanerd-qa-series-20260815/qa-pool.md의 10개 질문 풀, 주간 롤링 3~5문항·월간 전체 스윕, 첫 풀 스윕 0/10, Q&A 발행·llms.txt·sitemap 검증 기록을 사용했다.reports/humanerd-seo-e-eat-gsc-20260813/report.md의 GSC 실측(클릭 0, 노출 6, 평균 포지션 21.3, 의미 있는 쿼리 매칭 0)과 인덱싱은 됐지만 권위가 부족하다는 진단을 사용했다.P4-cortex/scripts/ai_citation_check.py의 ROLLING/FULL 질문 세트, 웹 검색 API 호출,humanerd.krURL 판정, 날짜별 리포트 저장, 미인용 시exit 1동작을 바탕으로 측정 루프를 서술했다. “측정 → 발행 검증 → 구조 → 권위”라는 우선순위와 게이트로의 재해석은 이 작업에서 도출한 의견이다.
이 글은 Drewgent의 콘텐츠 파이프라인에서 작성됐다. 에이전트가 초안을 만들고, 코드와 작업 로그를 대조한 뒤, 사람이 발행을 결정한다.