구조 규칙은 글쓰기에서 무너진다. 빌드 파이프라인에 박아라
본문 1바이트가 발행된 밤이 있었다
지난주, 우리 발행 파이프라인에서 이상한 일이 벌어졌다. 발행된 글 5건과 예약 발행 13건의 본문이 전부 1바이트였다. 누가 콘텐츠를 지운 게 아니었다. 발행 스크립트가 임시 파일의 경로를 잘못 잡으면서, --post_content=""로 글을 만들어버린 것이다. 그리고 같은 주, AI 인용 점검 스크립트가 돌려준 첫 풀 스윕 결과는 0/10이었다. 우리는 “질문형 H2를 쓰고, 문단은 2~4문장으로 자르고, 번호 목록을 넣어라”는 AI 검색 최적화(GEO) 가이드를 읽고 구조를 고치느라 바빴던 참이었다.
여기서 이 글의 주장이 나온다. AI 인용을 위한 구조 규칙은 ‘글쓰기 규칙’으로 두면 어느 순간 무너진다. 파이프라인에 ‘통과 조건(게이트)’으로 박힌 것들만 살아남는다. 우리 빌드 로그에는 그걸 증명하는 사건이 네 개 있다. 하나씩 짚고, 가이드가 말한 구조 규칙을 어떤 식으로 옮겼는지 공유한다. 외부에서 가져온 사실은 [외부 정보], 우리가 직접 겪고 고친 일은 [상호작용]으로 나눴고, 전체 출처는 마지막 ‘근거 출처’에 모았다.
[외부 정보] 가이드가 말한 것 — 구조는 ‘추출’을 위해 존재한다
SEOPress가 발표한 “How to Optimize Content for AI Overviews and Generative Search”(Benjamin Denis)는 생성형 엔진 최적화(GEO)를 5단계로 정리한다. 가트너의 2026년 전통 검색량 25% 감소 전망에서 시작해, 목표가 ‘랭킹’이 아니라 AI 답변 안에 인용되는 출처로 바뀌었다고 진단한다. 프롬프트 리서치(1단계)로 사람들이 실제로 묻는 대화형 질문을 채굴하고, 전문가 인용·최신 통계로 인용 가치를 만들고(2단계, 포함 시 가시성 30~40% 상승, 키워드 밀어넣기는 무최적화보다 10% 못했다는 Perplexity 실험), 추출 가능한 구조를 갖추고(3단계), 스키마·성능 같은 기술 기반을 다지고(4단계), ‘고정된 AI 순위는 없다’는 전제 아래 모니터링한다(5단계).
이 글과 가장 관련 깊은 건 3단계다. 가이드는 이렇게 쓴다. “많은 좋은 페이지가 이 단계에서 실패한다. AI가 정보를 쉽게 파싱하고 표면화할 수 없다면, 그 콘텐츠는 생성형 검색 결과에서 보이지 않게 된다.” 그리고 처방을 내린다. 역피라미드로 각 섹션 첫머리에 답을 두고, “Getting Started” 같은 모호한 헤딩 대신 질문형 헤딩(“프롬프트 리서치에 필요한 도구는 무엇인가?”)을 쓰고, 번호 목록·불릿·표로 쪼개고, 문단은 2~4문장, FAQ 섹션은 실제 질문을 H3로. 핵심 통찰은 하나다. ChatGPT는 번호 목록을 만나면 장문을 해석하지 않고 “3단계”를 자신 있게 인용한다. 구조는 글이 아름다워서가 아니라, AI가 급어낼(surface) 대상이 되기 위해 존재한다.
내가 이 가이드를 읽으며 놓친 것은 이랬다. 가이드의 순서 — 구조(3단계)가 모니터링(5단계)보다 먼저 — 는 문서의 논리 순서일 뿐이었다. 그런데 나는 그 순서를 실행 순서로 오해했고, 구조부터 손보기 시작했다. 실제 빌드 로그는 반대를 말해줬다.
[상호작용] 빌드 로그 — 규칙이 게이트로 바뀐 네 개의 순간
여기서부터는 우리가 실제로 운영 중인 콘텐츠 파이프라인(content_orchestrator.py, 수집 → 큐레이션 → 에이전트 초안 → 인간 편집 → 발행)의 기록이다. 이 글도 그 파이프라인이 만들었다. 네 사건 모두, 가이드의 구조 규칙을 ‘사람이 지키는 규칙’으로 뒀을 때 무슨 일이 벌어지는지 보여준다.
1. 빈 본문 사고 → “본문 없이는 발행하지 않는다”는 게이트
2026년 8월 9일의 사고다. slug 충돌 경로에서 발행 스크립트가 temp 파일 경로를 서로 다르게 잡으면서, --post_content=""로 5건이 발행되고 13건이 예약됐다. 구조 규칙의 관점에서 보면 이건 말이 안 되는 실패다. 질문형 H2든 2~4문장이든, 본문이 1바이트면 구조는 존재하지 않는다. 그런데 이 실패는 사람의 검수가 아니라 그냥 파이프라인이 통과시켰다. 나는 여기서 처음 알았다. “본문이 있어야 한다”는 전제조차 규칙으로 두면 뚫린다는 것을.
고친 방법은 규칙이 아니라 fail-closed 게이트였다. 발행 함수의 맨 윗줄, 아무것도 하기 전에 if not html or not html.strip(): return "empty content — publish aborted". 본문이 0바이트면 그 이후의 모든 단계(커버 생성, 미디어 업로드, WP 발행)가 시작되지 않는다. 규칙은 “지켜야 하는 것”이고, 게이트는 “통과할 수 없는 것”이다. 그 차이가 사고를 막았다.
2. 600초에서 8/9가 죽었다 → 시간 예산 게이트
두 번째 사건은 글쓰기 자체에서 벌어졌다. 작성기(에이전트) 타임아웃이 600초일 때, 9건 중 8건이 정확히 600초에서 실패했다. 재시도가 걸리면서 잠금(claim lock)만 쌓이고 진행은 0이 되는 루프가 생겼다. 로그를 보면 이유가 명확하다. 구조 규칙을 지키는 것, 특히 “질문형 헤딩으로 다시 쓰고, 문단을 2~4문장으로 자르는” 편집은 시간이 걸린다. 시간 예산이 빠듯하면 에이전트는 구조 규칙부터 버린다. 규칙이 실패한 게 아니라, 규칙을 지킬 여유가 없었다.
고친 것은 세 가지다. 타임아웃 600→900초(그래도 세션은 15분으로 바운드), 타임아웃이어도 초안 파일을 스캔해 회수하는 경로(작업은 끝났는데 마지막 출력만 누락된 경우가 8/11 실패 패턴이었다), 그리고 회당 write 배치 상한 10건과 WIP 상한 5·일일 발행 상한 3. 이것들은 구조 규칙이 아니라 자원 예산이지만, 결과적으로 구조 규칙이 지켜질 수 있는 전제가 됐다. “질문형 H2를 써라”가 아니라 “질문형 H2를 쓸 시간과 진행률을 보장한다”로 바꾼 것이다.
3. wp-cli 필터 버그 → 검증 계층
세 번째는 이번 주(8월 15일)의 인시던트다. 테스트 글 하나를 지우려던 명령이, wp-cli 2.12의 --post_title 필터가 조용히 무시되는 버그(전체를 반환)에 걸려 발행 포스트 185개를 --force로 퍼지했다. 복구하는 데 하루가 걸렸다. 트래시에 남은 22개를 원상 복구하고, 프리-인시던트 배포 캐시에서 185개를 스크랩해 재생성했고, 재실행 중 CSV 파싱 버그로 -2/-3 접미사 중복 201개가 생겨 다시 정리했다. 예약분 15개는 잔존 손실로 남았다.
이 사건이 이 글과 무관해 보일 수 있다. 그런데 가이드 5단계 ‘모니터링’이 실제로 작동하려면, 측정·관리 도구를 먼저 신뢰할 수 있어야 한다. 인용 점검 cron이 “0/10″이라고 말해도, 그 숫자를 만드는 도구가 필터를 무시하고 전체를 지운다면 그 숫자는 아무 의미도 없다. 그래서 우리가 만든 재발 방지 규칙은 전부 ‘신뢰하지 않는’ 패턴이다. 필터 인자를 그대로 믿지 말고 --format=json + 파싱 검증 후 사용, --force 없이 ID 목록을 명시적으로 검증 후 삭제, 삭제 전 스냅샷. 측정 전에 검증 — 이것도 일종의 게이트다.
4. 구조가 계약이 된 세 곳 — 그리고 0/10이라는 실측
같은 파이프라인 안에서, 가이드가 말한 구조가 ‘규칙’이 아니라 ‘계약’으로 존재하는 곳이 세 군데 있다. 이 세 곳은 사람이 까먹어도 무너지지 않는다. 첫째, 첫 h2가 곧 제목이다. 발행 스크립트는 HTML의 첫 h2를 extract_title_from_html로 뽑아 제목으로 쓴다. 즉 ‘질문형 첫 헤딩’은 선택이 아니라, 구조가 곧 메타데이터가 되는 지점이다. 둘째, 이미지 경로가 계약이다. 초안에 covers/xxx.png로 넣은 로컬 이미지는 발행 시 자동으로 WP 미디어에 업로드되고 WebP로 변환되고 본문 src가 재작성된다. “이미지를 넣어라”는 지침이 아니라 파이프라인이 실행하는 계약이다. 셋째, 인용 점검 cron(ai_citation_check.py). 고정 질문 세트를 LLM 웹서치에 넣고 humanerd.kr in 인용 URL이라는 이진 판정으로 날짜별 리포트를 남기고, 미인용이면 exit 1로 알림을 띄운다.
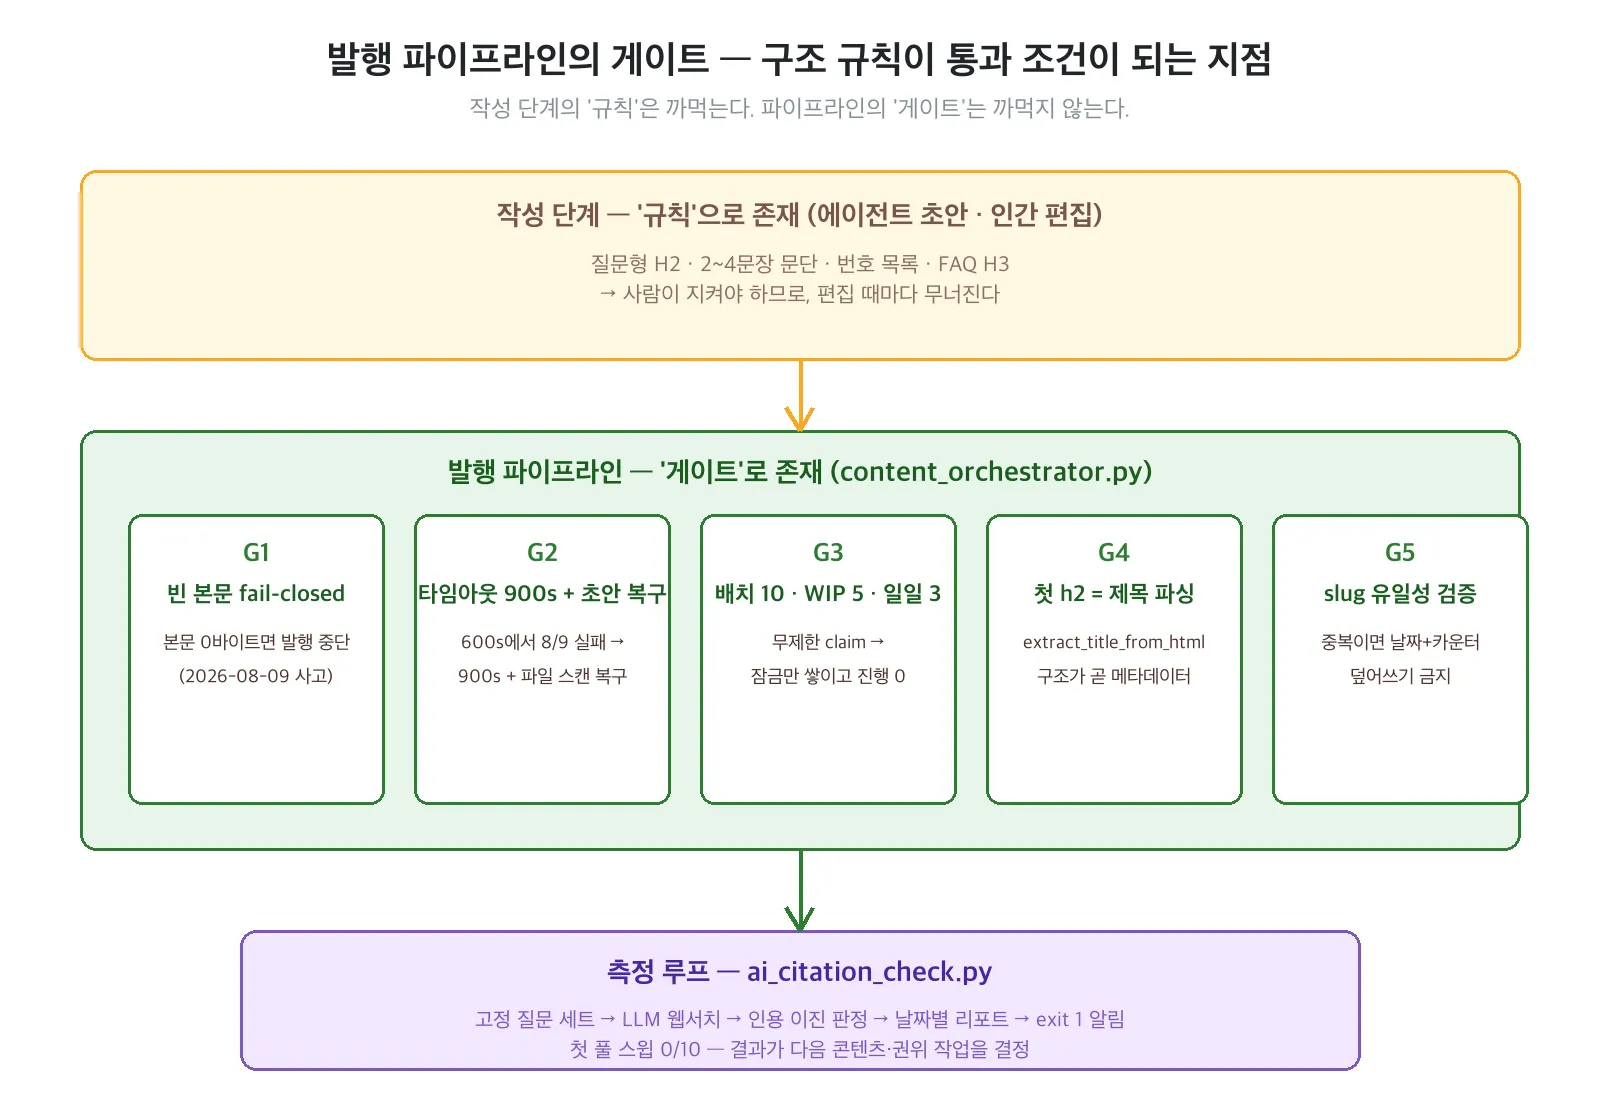
그리고 그 측정 루프가 돌려준 실측이 0/10이었다. 실망스럽지만 정확히 이 숫자가 ‘계약’이 왜 필요한지 보여준다. 콘텐츠 구조를 아무리 잘 지켜도, 발행 경로가 무너지거나 측정이 불신이면 그 구조는 AI에게 아무것도 아니다. 구조는 존재하고, 발행되고, 측정되는 순간에만 추출 대상이 된다.
가이드의 규칙을 게이트로 다시 써보기
여기까지가 우리 빌드 로그다. 이제 이 경험을 표 하나로 압축할 수 있다. 가이드가 준 구조 규칙을, ‘규칙으로 뒀을 때’와 ‘게이트로 뒀을 때’로 나눠보면 이렇게 된다.
| 가이드의 조항 | 규칙으로 두면 | 게이트로 두면 |
|---|---|---|
| 질문형 H2 | 편집 중 서문 헤딩으로 되돌아감 | 첫 h2 = 제목 파싱 — 구조가 메타데이터 |
| 본문이 있어야 한다 | 검수를 통과한 빈 글 | fail-closed — 0바이트면 발행 중단 |
| 구조를 지킬 시간 | 빠듯하면 구조부터 생략 | 타임아웃 900s + 초안 회수 + 배치 상한 |
| 모니터링 | “나중에 확인”으로 미뤄짐 | 주간 cron + exit 1 알림 |
해법 — 당신 파이프라인에 옮길 4단계
가이드를 ‘순서’로 읽으면 구조(3단계)가 측정(5단계)보다 먼저 와서, 우리처럼 구조만 고치고 방향을 잃는다. 빌드 로그로 읽으면 우선순위가 뒤집힌다. 측정과 검증이 먼저, 구조가 그다음. 그 순서대로, 오늘 당신 프로젝트에 옮길 네 단계를 정리했다.
- 규칙 목록을 ‘게이트 후보’로 다시 써라. “본문 없이는 발행하지 않는다”, “FAQ 섹션 없으면 경고”, “첫 문단이 4문장을 넘으면 경고”처럼 pass/fail로 표현할 수 있는 항목을 골라라. “질문형 H2를 써라”는 게이트가 될 수 없고, “첫 h2를 제목으로 파싱한다”는 게이트가 된다. 표현이 바뀌면 실행이 바뀐다.
- 자원 예산을 게이트에 포함하라. 타임아웃, 배치 상한, WIP 상한. 구조를 지킬 여유가 없으면 규칙은 폐기된다. 예산은 규칙이 지켜질 수 있는 전제 조건이다.
- 구조를 파싱으로 강제하라. “첫 문단의 첫 문장이 답인가” 같은 추출 검사를 발행 훅에 박아라. 사람은 규칙을 까먹지만, 파서는 까먹지 않는다. 파이프라인이 구조에서 뭔가를 뽑아 쓰는 지점(제목, 요약, 스키마)을 만들면 구조가 계약이 된다.
- 발행 뒤에 측정을, 측정 전에 검증을. 고정 질문 세트로 인용 여부를 기록하는 주간 cron을 돌려라. 동시에, 그 측정·관리 도구의 필터와 삭제 명령을 먼저 신뢰 검증하라. 측정 도구가 전체를 지우는 파이프라인은 숫자를 만들어내지 못한다.
이 4단계의 전체 논리는 한 문장으로 떨어진다. 게이트가 없는 규칙은 사라진다. 우리의 0/10은 구조가 틀려서가 아니라, 구조를 지키는 경로가 그때까지 규칙에만 의존했기 때문이다.
이번 주, ‘사람이 지키는 규칙’ 하나를 게이트로 옮겨보라
당신의 콘텐츠·배포 파이프라인에서 “항상 지키기로 했는데, 어느 순간 안 지켜지고 있는” 구조 규칙이 하나쯤 있을 것이다. 그것이 어떤 것이든, 이번 주에 그 하나만 게이트로 만들어보라. 가장 쉬운 출발점은 이렇다. 발행 스크립트 맨 위에 “본문이 비면 중단”을 추가하고, 오늘 쓴 글의 첫 h2가 실제 질문인지 한 번만 확인하는 체크를 붙여라. 규칙이 게이트가 되는 순간을 한 번 겪으면, 가이드의 나머지 조항도 자연스럽게 같은 방식으로 옮기고 싶어진다.
직접 만들어봤다면 댓글로 공유해달라. “어떤 규칙을, 어떤 게이트로 바꿨는지” 한 줄이면 충분하다. 남의 게이트 목록이 이 주제에서 가장 값진 데이터다.
근거 출처
외부 정보 (하베스터 수집)
- “How to Optimize Content for AI Overviews and Generative Search”(Benjamin Denis, SEOPress, 2026-02-12; 하베스터 수집본 how-to-optimize-content-for-ai-overviews-and-generative-search_202606051640.md, 큐레이션 점수 0.75) — 가트너의 2026년 전통 검색량 25% 감소 전망, GEO의 정의(링크 목록 대신 답을 만드는 AI 검색 경험을 위한 콘텐츠 최적화), 목표 전환(랭킹·클릭 → 인용), 엘리 슈워츠의 ChatGPT 전환율 인용, 5단계 실행 계획(프롬프트 리서치, 전문가 인용·최신 통계의 30~40% 가시성 상승과 Perplexity 키워드 스터핑 -10% 실험, 역피라미드·질문형 H2·번호 목록·2~4문장 문단·FAQ H3의 추출 가능한 구조와 “많은 좋은 페이지가 이 단계에서 실패한다”는 문장, Article·FAQPage 스키마와 라이트하우스 90점 이상의 기술 기반, “고정된 AI 순위는 없다”는 모니터링 원칙) 등 본문의 외부 수치·주장은 모두 이 가이드에서 가져왔다.
상호작용 (에이전트-드루 대화·작업)
content_orchestrator.py(3-mode 콘텐츠 파이프라인: schedule → write → publish)에 기록된 실제 결정·사고: 2026-08-09 빈 본문 발행 사고(5건 publish + 13건 future 전부 본문 1바이트, slug 충돌 경로의 temp 경로 불일치)와 그로부터 도입된 fail-closed 게이트(“empty content — publish aborted”), 2026-08-12 작성기 타임아웃 600→900 초 변경(9건 중 8건이 정확히 600초에서 실패, 무제한 claim → 잠금만 쌓이고 진행 0이 되는 루프 방지를 위한 WRITE_BATCH_CAP=10, WIP_LIMIT=5, MAX_POSTS_PER_DAY=3), 2026-08-15 타임아웃 초안 회수(_recover_draft_slug — 작업은 끝났는데 마지막 출력만 누락된 8/11 실패 패턴),extract_title_from_html이 첫 h2를 제목으로 파싱하는 구조 계약, covers/ 로컬 이미지 → WP 미디어 업로드 → WebP 변환 → 본문 src 재작성 파이프라인은 직접 확인·작업한 경험이다.- 2026-08-15 WP 인시던트 복구 기록(
reports/humanerd-wp-incident-recovery-20260815/report.md): wp-cli 2.12--post_title필터 무시 버그로 185개 발행 포스트 전량--force퍼지, 22개 트래시 복구와 배포 캐시 기반 185개 재생성, 재실행 중 CSV 파싱 버그로 인한 -2/-3 접미사 중복 201개 정리, future 15개 잔존 손실, 재발 방지 패턴(필터 인자 불신 +--format=json파싱 검증, 삭제 전 스냅샷,--force사용 금지). ai_citation_check.py의 첫 풀 스윕 결과(2026-08-15, 요약 0/10 인용,reports/ai-citation/2026-08-15.md), 고정 질문 세트(ROLLING 3문항·FULL 10문항), OpenAI Responses APIweb_search_preview인용 URL 수집,humanerd.kr in urls이진 판정, 미인용 시exit 1크론 알림 설계는 직접 구현·실행한 경험이다.- “규칙이 게이트로 바뀐 네 개의 순간”의 해석, ‘게이트가 없는 규칙은 사라진다’는 통찰, 4단계 해법(규칙→게이트 재표현, 자원 예산, 파싱 강제, 측정 전 검증)과 게이트 다이어그램·비교표는 이 빌드 작업에서 직접 도출·제작한 것이다.
이 글은 Drewgent(개인 AI 에이전트 시스템)의 콘텐츠 파이프라인을 통해 작성되었다. 에이전트가 초안을 쓰고, 인간이 편집하고, cron이 발행한다.